정렬된 리스트에서 값 2가 몇 번 나오는지 찾는다면, 일치하는 위치 한 개만 찾는 이진 탐색으로는 부족합니다. bisect_left로 시작 경계를, bisect_right로 끝 경계를 찾고 두 값의 차이를 구하면 중복 개수를 얻습니다.
Python 3.12.14에서 실행했습니다. 표준 라이브러리만 사용하며 리스트가 오름차순으로 정렬되어 있다는 전제가 필요합니다.
1. 경계 두 개로 중복 개수를 구합니다
from bisect import bisect_left, bisect_right

values = [1, 2, 2, 2, 4, 7]
x = 2
left = bisect_left(values, x)
right = bisect_right(values, x)

print(left, right)
print(values[left:right])
print("개수:", right - left)
1 4
[2, 2, 2]
개수: 3인덱스는 0부터 시작합니다. 왼쪽 경계 1은 첫 번째 2의 앞이고, 오른쪽 경계 4는 마지막 2의 바로 뒤입니다. 따라서 같은 값이 있는 구간은 [left, right)입니다.
오른쪽 경계는 마지막 일치 인덱스 자체가 아닙니다. 일치하는 값이 있을 때 마지막 인덱스는 right - 1이며, 존재하지 않는 경우에는 이 계산으로 원소를 꺼내면 안 됩니다.
2. 값이 없어도 삽입 위치를 반환합니다
for x in [0, 2, 3, 8]:
    left = bisect_left(values, x)
    right = bisect_right(values, x)
    print(x, left, right, right - left)
0 0 0 0
2 1 4 3
3 4 4 0
8 6 6 0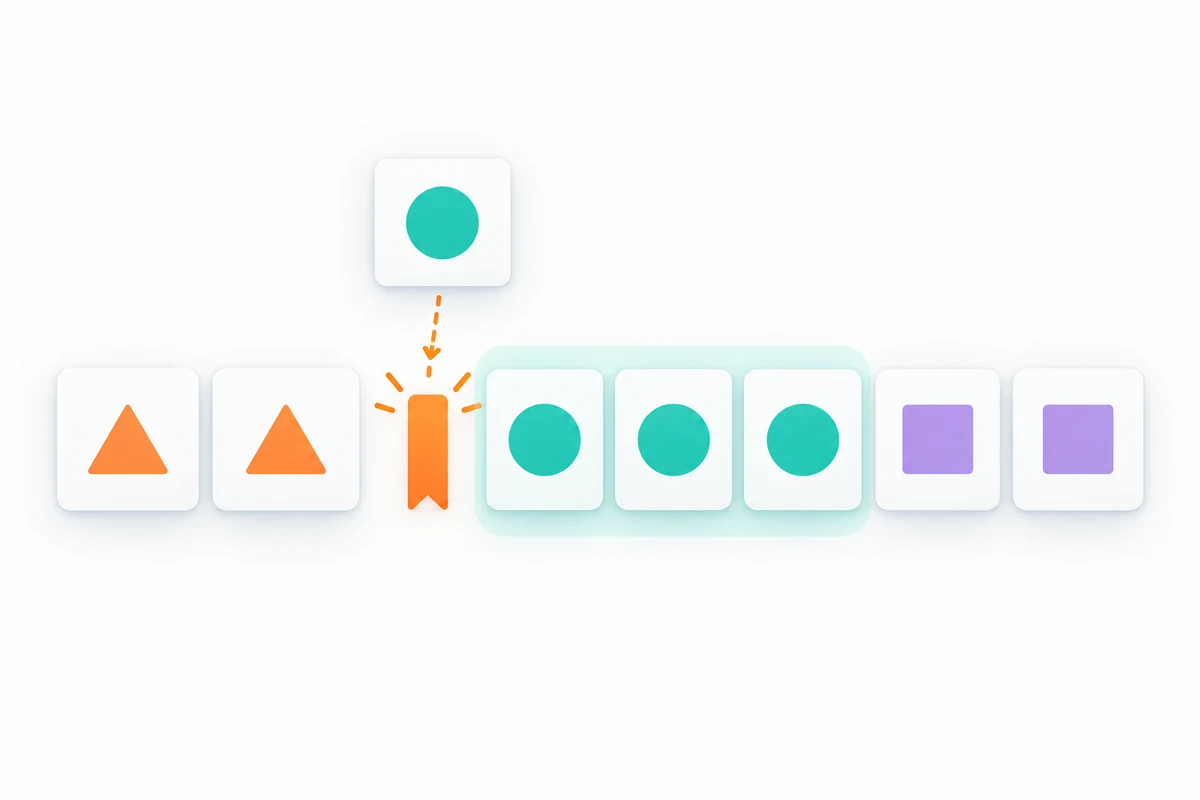
bisect_left(values, 3)의 결과 4는 값 3을 찾았다는 뜻이 아닙니다. 정렬을 유지하며 3을 넣을 수 있는 위치입니다. 값 8의 경계 6처럼 len(values)가 반환될 수도 있습니다.
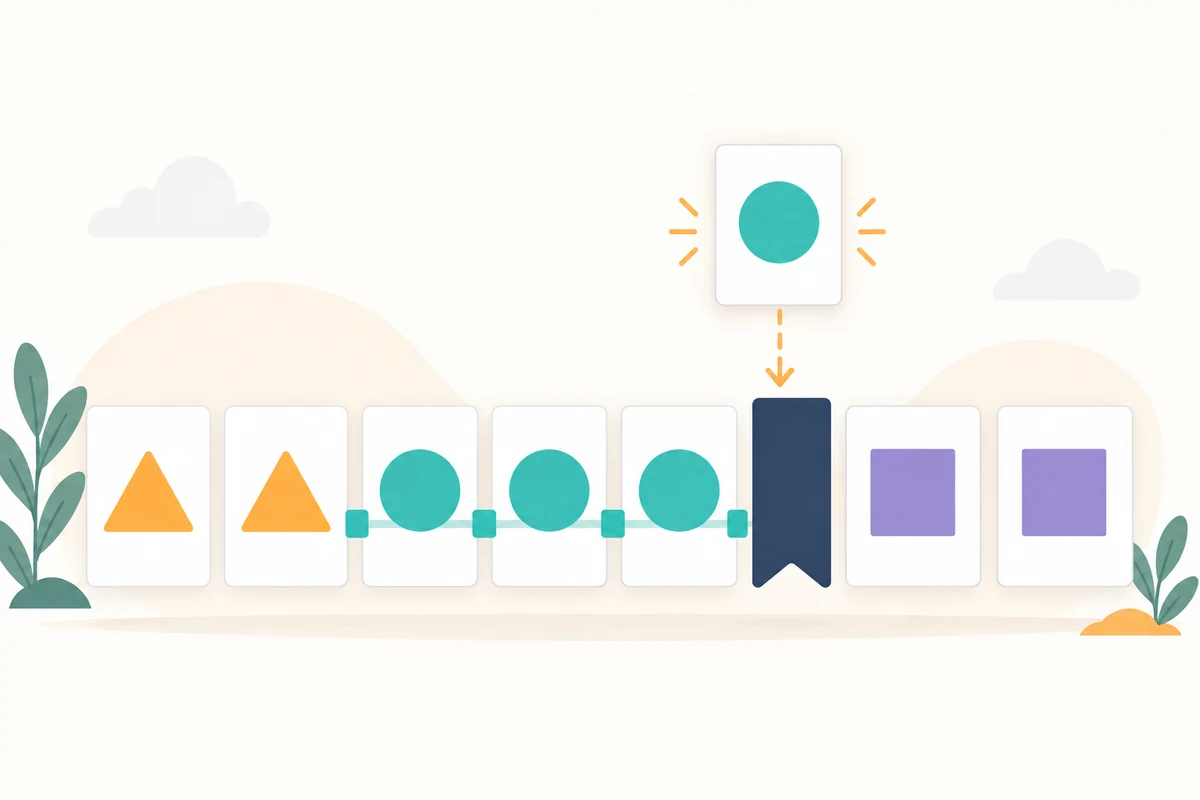
존재 여부만 필요하면 경계를 얻은 뒤 길이와 실제 값을 함께 검사합니다.
def contains(sorted_values, x):
    i = bisect_left(sorted_values, x)
    return i < len(sorted_values) and sorted_values[i] == x

print(contains(values, 3))
print(contains(values, 7))
print(contains([], 7))
False
True
False3. 양 끝값의 포함 여부로 범위 검색을 만듭니다
lower, upper = 2, 4
start = bisect_left(values, lower)
end = bisect_right(values, upper)
print(values[start:end])
print("개수:", end - start)

# 위쪽 끝값 4를 제외하는 [2, 4) 구간
end_exclusive = bisect_left(values, upper)
print(values[start:end_exclusive])
[2, 2, 2, 4]
개수: 4
[2, 2, 2]2 이상 4 이하에서는 왼쪽에 bisect_left(2), 오른쪽에 bisect_right(4)를 씁니다. 2 이상 4 미만에서는 두 경계 모두 bisect_left입니다. 아래쪽 끝값을 제외하려면 시작 경계를 bisect_right로 바꿉니다.
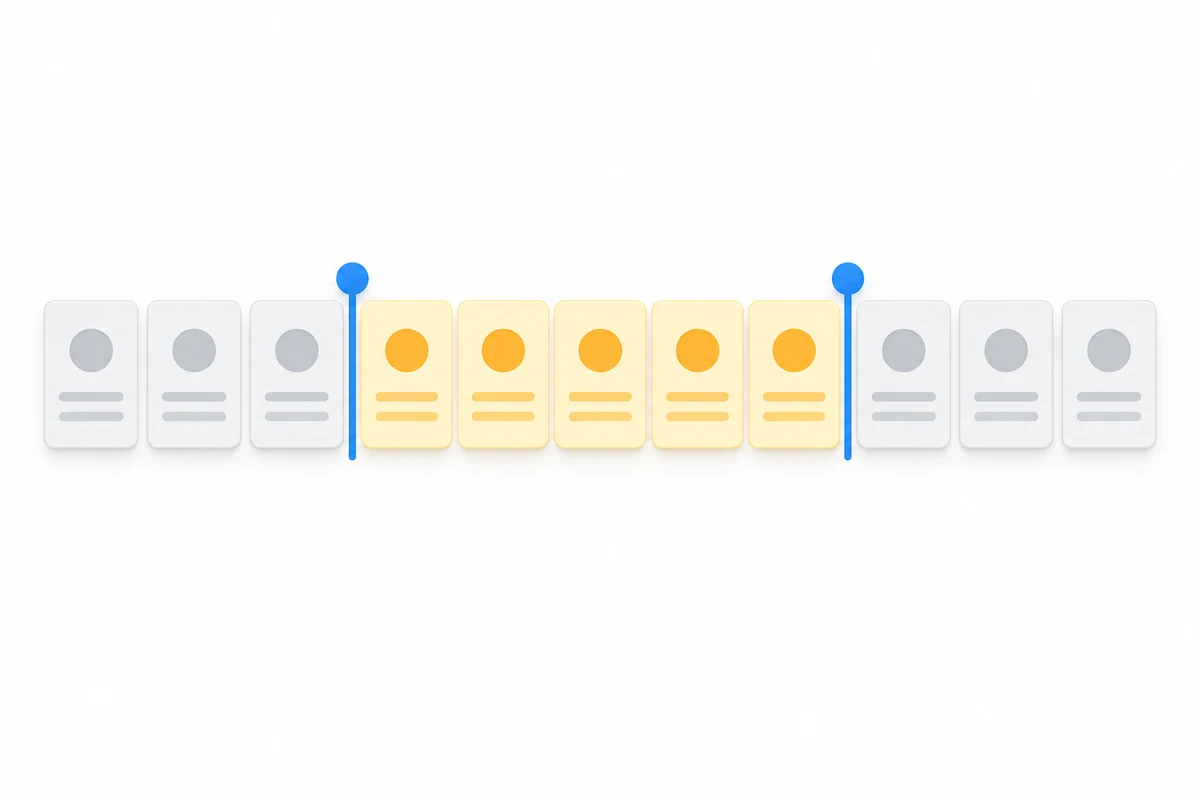
범위가 뒤집힌 입력은 검색 전에 처리하세요. 개수만 필요하면 end - start만 구하고, 슬라이스 복사는 생략할 수 있습니다.
4. 정렬 전제와 비용을 확인합니다
def count_between(sorted_values, lower, upper):
    if lower > upper:
        return 0
    return (bisect_right(sorted_values, upper)
            - bisect_left(sorted_values, lower))

assert count_between(values, 2, 4) == 4
assert count_between(values, 3, 3) == 0
assert count_between([], 2, 4) == 0
assert count_between(values, 4, 2) == 0
assert bisect_right(values, 2) - bisect_left(values, 2) == values.count(2)
print("검증 통과")
bisect는 정렬을 확인하거나 자동 정렬하지 않습니다. 정렬되지 않은 리스트에 적용한 결과를 검색 답으로 쓰면 안 됩니다. 여러 번 조회할 자료라면 한 번 정렬해 두고, 조회 사이에 정렬 순서를 깨뜨리는 변경이 없는지 관리합니다.
리스트에서 경계 탐색은 O(log n)입니다. 하지만 values[start:end]는 선택한 원소를 복사하며, insort로 리스트에 끼워 넣는 작업은 원소 이동 때문에 O(n)입니다. 이진 탐색을 사용했다고 전체 삽입 작업까지 O(log n)이 되는 것은 아닙니다.
중복과 같은 값이라는 판단은 정렬·비교 기준이 일관된 일반 정수 자료를 가정했습니다. NaN처럼 비교가 일반적이지 않은 값이나 사용자 정의 객체, 여러 스레드의 동시 변경은 이 예제의 범위에 포함하지 않습니다.
5. 핵심 정리
왼쪽 경계는 같은 값 앞, 오른쪽 경계는 같은 값 뒤입니다. 개수는 두 경계의 차이이며, 존재 여부는 반환 인덱스와 실제 값을 함께 검사합니다. 구간 검색에서는 양 끝값을 포함할지 먼저 정하세요.
원본을 유지하며 정렬할지 결정하는 방법은 sorted와 list.sort의 차이에서 이어서 확인할 수 있습니다.
'개발 > 트러블슈팅' 카테고리의 다른 글
| Python deque(maxlen)에서 데이터가 사라지는 이유: 자동 삭제와 Queue (0) | 2026.10.08 |
|---|---|
| Python zip에서 데이터가 사라질 때: strict=True와 zip_longest 선택 (0) | 2026.10.07 |
| Python heapq 동점에서 TypeError가 날 때: 고유 순번으로 해결하기 (0) | 2026.10.05 |
| Python logging 중복 출력 해결: handlers와 propagate 확인 순서 (1) | 2026.10.04 |
| Bash 파이프라인에서 오류를 놓칠 때: pipefail과 PIPESTATUS 확인 순서 (0) | 2026.09.28 |


댓글