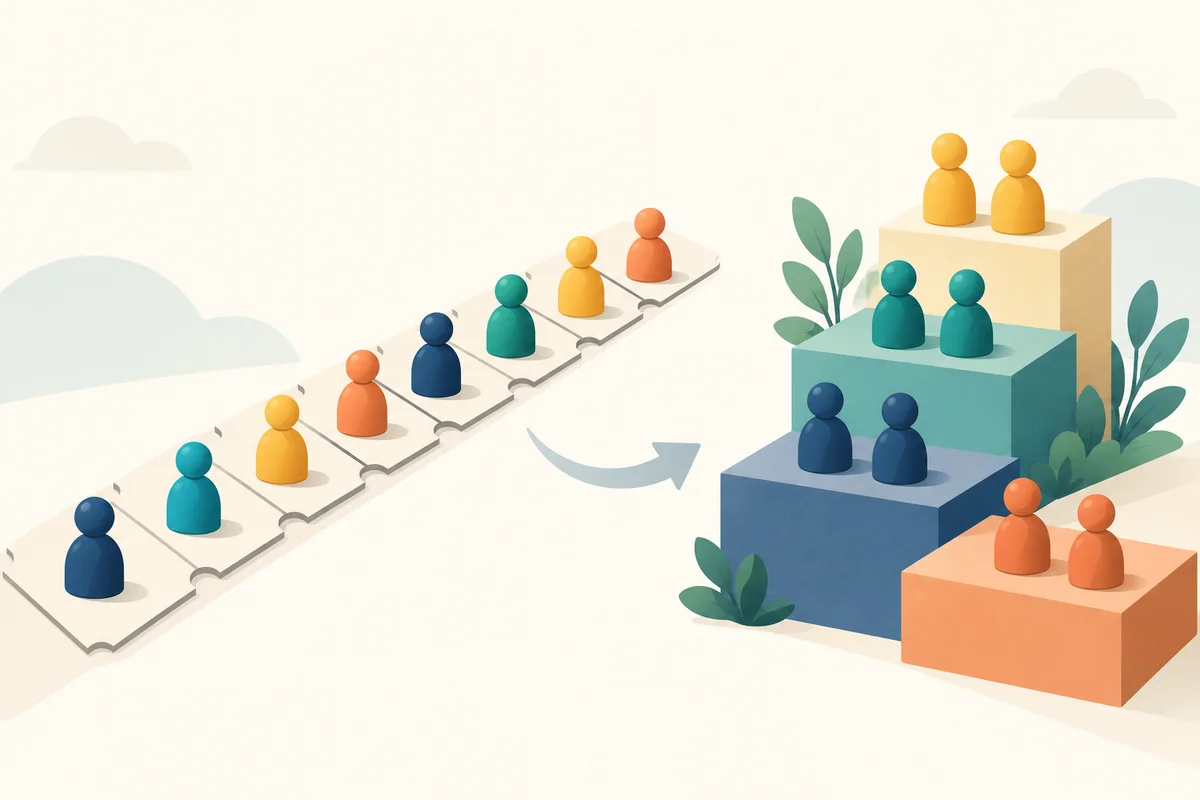
“상위 3개”를 조회했는데 동점에서 결과가 달라진다면, 사람 수를 제한하는지, 경쟁 순위를 제한하는지, 서로 다른 점수 그룹을 제한하는지부터 정하세요. ROW_NUMBER는 각 행의 번호, RANK는 동점 뒤 순위 간격, DENSE_RANK는 간격 없는 점수 그룹 순위를 만듭니다.
SQLite 3.53.1에서 검증한 가상 점수 자료입니다. 여섯 사람 중 B·C·D가 90점으로 동점입니다. 실제 업무에서 개인정보 대신 사용하는 작은 예제이며, 점수는 NULL이 없는 정수로 한정합니다.
1. 동점이 있는 데이터를 준비합니다
CREATE TABLE scores (
    id INTEGER PRIMARY KEY,
    name TEXT NOT NULL,
    score INTEGER NOT NULL
);
INSERT INTO scores VALUES
    (1, 'A', 100), (2, 'B', 90), (3, 'C', 90),
    (4, 'D', 90), (5, 'E', 80), (6, 'F', 70);
같은 SQLite 연결에서 아래 SQL을 위에서부터 실행하세요. id는 사람별 고유 값이며, 이번 예제에서 동점 중 누구를 먼저 고를지 결정하는 기준입니다. 실제 업무의 우선 기준이 등록 시각이라면 그 기준을 사용하고 마지막에 고유 키를 덧붙여 순서를 확정해야 합니다.
2. 같은 자료에 세 가지 순위를 붙입니다
SELECT id, name, score,
       ROW_NUMBER() OVER (ORDER BY score DESC, id ASC) AS rn,
       RANK() OVER (ORDER BY score DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY score DESC) AS drnk
FROM scores
ORDER BY score DESC, id ASC;
id | name | score | rn | rnk | drnk
1 | A | 100 | 1 | 1 | 1
2 | B | 90 | 2 | 2 | 2
3 | C | 90 | 3 | 2 | 2
4 | D | 90 | 4 | 2 | 2
5 | E | 80 | 5 | 5 | 3
6 | F | 70 | 6 | 6 | 4ROW_NUMBER는 1~6을 한 번씩 부여합니다. RANK는 90점 세 명을 모두 2위로 두고 다음 80점은 5위로 둡니다. DENSE_RANK는 90점 다음 점수인 80점을 3위로 둡니다. 따라서 이 자료에는 경쟁 순위 3위 행이 없고, 점수 그룹의 3위는 존재합니다.
3. 정확히 세 사람을 고르려면 행 번호를 거릅니다
WITH ranked AS (
    SELECT id, name, score,
           ROW_NUMBER() OVER (ORDER BY score DESC, id ASC) AS rn,
           RANK() OVER (ORDER BY score DESC) AS rnk,
           DENSE_RANK() OVER (ORDER BY score DESC) AS drnk
    FROM scores
)
SELECT name, score
FROM ranked
WHERE rn <= 3
ORDER BY rn;
name | score
A | 100
B | 90
C | 90A·B·C만 남고 같은 90점의 D는 제외됩니다. “정확히 세 명”이라는 요청에는 맞지만 “90점 동점을 모두 포함”하는 요청에는 맞지 않습니다. 후보가 세 명보다 적으면 결과도 세 명보다 적으며, ROW_NUMBER가 없는 사람을 만들어 주지는 않습니다.
윈도 함수의 별칭 rn을 같은 SELECT의 WHERE에서 바로 사용하지 않고 CTE 바깥에서 거릅니다. 최종 출력 순서는 바깥 ORDER BY로 지정합니다.
4. 동점을 포함하는 두 기준도 서로 다릅니다
WITH ranked AS (
    SELECT id, name, score,
           RANK() OVER (ORDER BY score DESC) AS rnk,
           DENSE_RANK() OVER (ORDER BY score DESC) AS drnk
    FROM scores
)
SELECT 'RANK' AS rule, name, score
FROM ranked
WHERE rnk <= 3
UNION ALL
SELECT 'DENSE_RANK' AS rule, name, score
FROM ranked
WHERE drnk <= 3
ORDER BY rule, score DESC, name;
rule | name | score
DENSE_RANK | A | 100
DENSE_RANK | B | 90
DENSE_RANK | C | 90
DENSE_RANK | D | 90
DENSE_RANK | E | 80
RANK | A | 100
RANK | B | 90
RANK | C | 90
RANK | D | 90RANK≤3은 A·B·C·D 네 명입니다. DENSE_RANK≤3은 100·90·80이라는 상위 세 점수 그룹에 속한 A~E 다섯 명입니다. 동점을 보존하면 결과 행 수가 3을 넘을 수 있습니다. 숫자 3만 같다고 두 요청을 같은 필터로 구현하면 안 됩니다.
5. 고유 키를 RANK 안에 넣으면 동점이 풀립니다
SELECT name, score,
       RANK() OVER (ORDER BY score DESC, id ASC) AS rnk_with_id
FROM scores
ORDER BY score DESC, id ASC;
name | score | rnk_with_id
A | 100 | 1
B | 90 | 2
C | 90 | 3
D | 90 | 4
E | 80 | 5
F | 70 | 6RANK의 동점은 윈도 ORDER BY 전체 값이 같은 행끼리 판단합니다. 고유 id까지 넣으면 B·C·D도 서로 다른 정렬 값이 되어 순위가 나뉩니다. 점수 동점을 유지하려면 RANK·DENSE_RANK에는 점수 기준을 두고, 보기 순서에 필요한 id는 바깥 ORDER BY에 둡니다.
부서별 순위라면 OVER 안에 PARTITION BY 부서를 추가해 별도 순위를 만듭니다. NULL 점수 포함 여부와 동점 선정 규칙도 미리 정하세요. 최신 주문 한 건을 고르는 목적이라면 고객별 최신 주문의 ROW_NUMBER와 동점 기준을 함께 보면 용도를 구분하기 쉽습니다.
정리: 인원 제한은 ROW_NUMBER, 경쟁 순위 제한은 RANK, 서로 다른 점수 그룹 제한은 DENSE_RANK입니다. 기준을 먼저 문장으로 쓰고 예상 인원과 동점 포함 여부를 작은 자료로 확인하세요.
'데이터베이스(SQL) > 데이터베이스 개념' 카테고리의 다른 글
| SQL LAG가 전날 값을 못 찾는 이유: 이전 행과 전일 비교 (0) | 2026.10.09 |
|---|---|
| SQL 조건부 집계가 전체 행을 세는 이유: COUNT·SUM·CASE 실습 (0) | 2026.10.07 |
| SQL 평균의 평균이 틀리는 이유: SUM·COUNT로 가중 평균 계산 (0) | 2026.10.06 |
| SQL 누적합이 같은 날짜에서 뛰는 이유: ROWS와 RANGE 실습 (0) | 2026.10.04 |
| SQL JOIN 후 SUM이 커지는 이유: 상세 테이블 선집계로 중복 막기 (0) | 2026.10.03 |


댓글