그룹 평균을 계산한 Series를 원본 DataFrame 열에 바로 넣었더니 NaN이 생겼다면, 두 결과의 인덱스를 비교하세요. 집계 결과는 그룹 키, 원본은 행 라벨을 기준으로 할 수 있습니다. 원본 각 행에 그룹 통계를 붙이려면 transform을 쓰거나, 그룹 키로 map을 적용하는 방식이 적합합니다.
아래 실습은 pandas 2.2.3·Python 3.12.14에서 실행했습니다. 이 글은 그룹이 빠지는 문제가 아니라 계산된 값을 어느 행에 배치할지를 다룹니다. 코드 블록은 위부터 같은 세션에서 실행하세요.
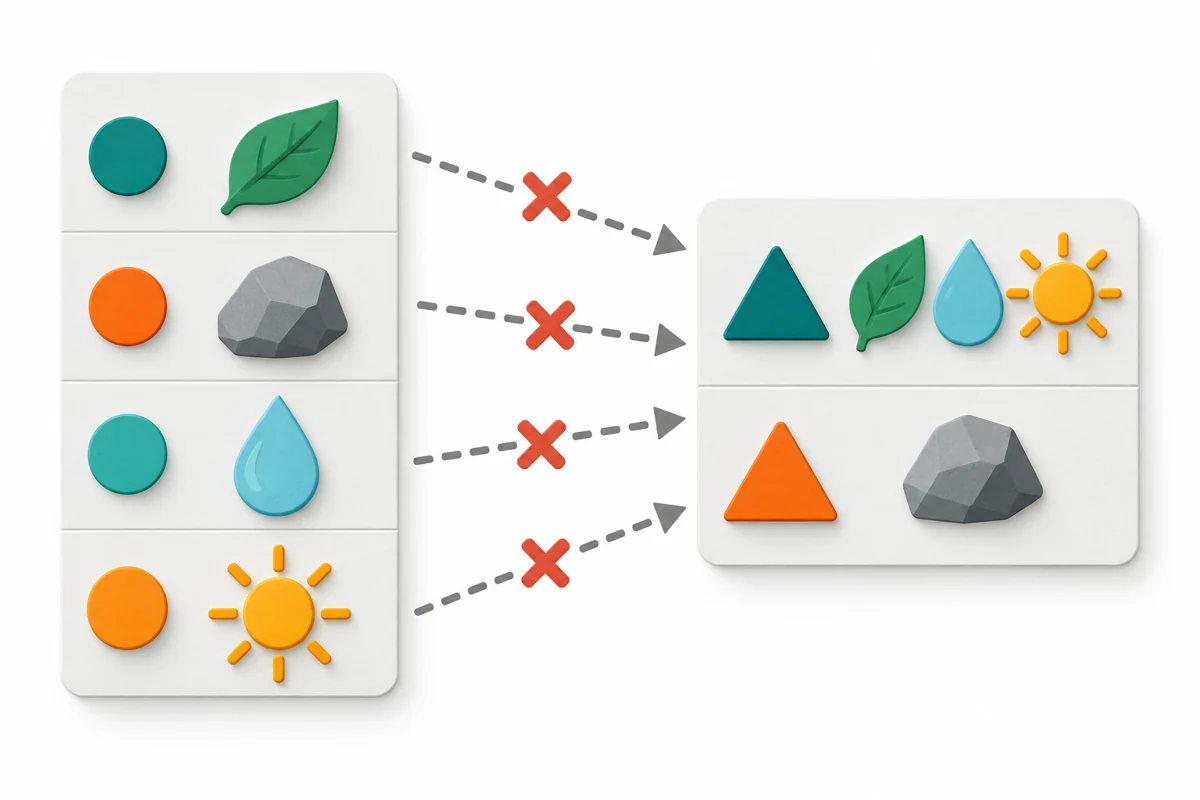
1. 그룹 인덱스와 원본 행 인덱스가 다릅니다
import pandas as pd

df = pd.DataFrame({
    "team": ["B", "A", "B", "A"],
    "sales": [20, 10, 40, 30],
}, index=[10, 20, 30, 40])

means = df.groupby("team")["sales"].mean()
df["wrong"] = means
print("row labels:", df.index.tolist())
print("group labels:", means.index.tolist())
print("group means:", means.to_dict())
print("missing assigned:", int(df["wrong"].isna().sum()))
row labels: [10, 20, 30, 40]
group labels: ['A', 'B']
group means: {'A': 20.0, 'B': 30.0}
missing assigned: 4A의 평균은 20, B의 평균은 30으로 계산 자체는 맞습니다. 다만 Series를 열에 대입하면 값 두 개를 네 행에 알아서 반복하지 않고, 원본 행 라벨 10·20·30·40에 맞춰 정렬합니다. 그룹 라벨 A·B와 일치하지 않으므로 네 행이 모두 결측으로 채워졌습니다.
2. transform으로 원본 행에 대응하는 결과를 만듭니다
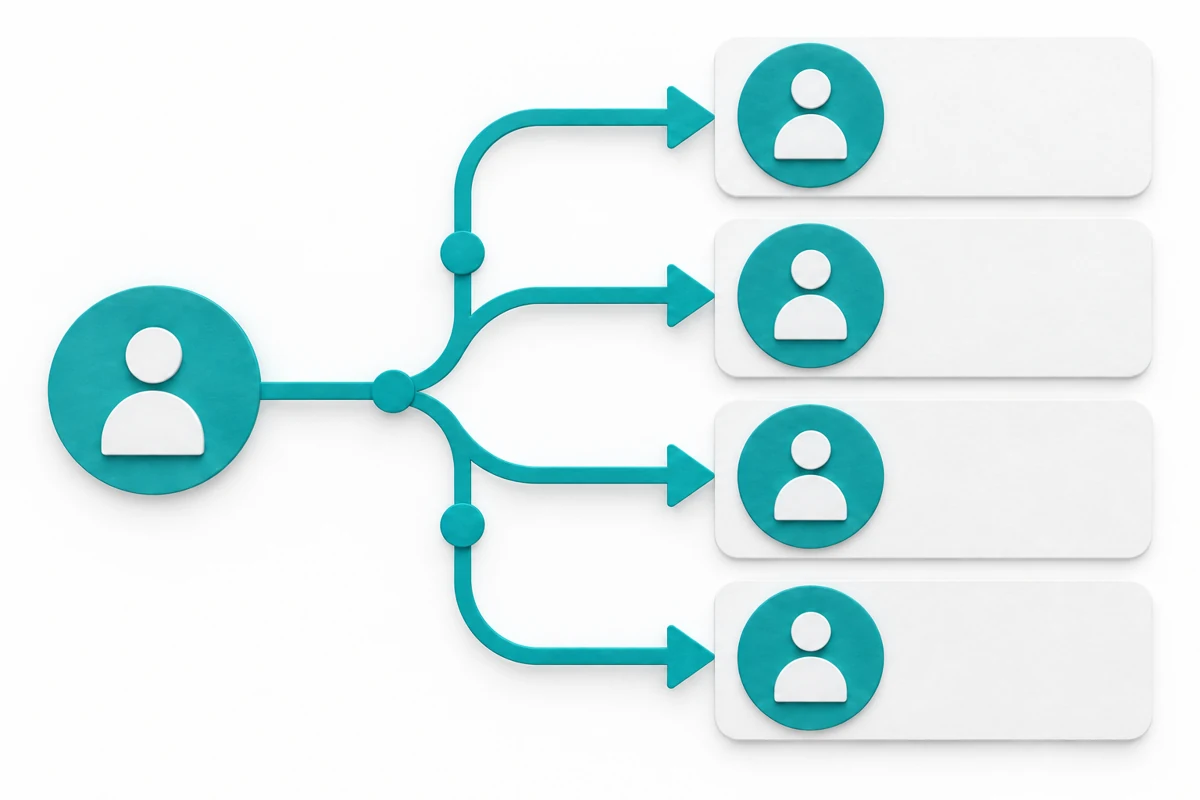
group_mean = df.groupby("team")["sales"].transform("mean")
df["team_mean"] = group_mean
df["difference"] = df["sales"] - group_mean
print("same index:", group_mean.index.equals(df.index))
print("team mean:", df["team_mean"].tolist())
print("difference:", df["difference"].tolist())
same index: True
team mean: [30.0, 20.0, 30.0, 20.0]
difference: [-10.0, -10.0, 10.0, 10.0]B 행에는 30, A 행에는 20이 들어가며 원본의 행 수와 순서, 행 라벨을 유지합니다. 그룹마다 한 값을 줄이는 mean 집계와 달리, transform은 그룹 계산을 각 원본 행에 대응하는 결과로 돌려줍니다. 이 예제처럼 그룹 평균 대비 차이·비율을 계산할 때 유용합니다.
3. reset_index나 to_numpy로 정렬 문제를 숨기지 마세요
try:
    df["wrong_array"] = means.to_numpy()
except ValueError as exc:
    print("four rows, two values:", type(exc).__name__)

tiny = pd.DataFrame({"team": ["B", "A"], "sales": [20, 10]})
tiny_means = tiny.groupby("team")["sales"].mean()
tiny["by_position"] = tiny_means.to_numpy()
tiny["by_group"] = tiny.groupby("team")["sales"].transform("mean")
print("team:", tiny["team"].tolist())
print("by position:", tiny["by_position"].tolist())
print("by group:", tiny["by_group"].tolist())
four rows, two values: ValueError
team: ['B', 'A']
by position: [10.0, 20.0]
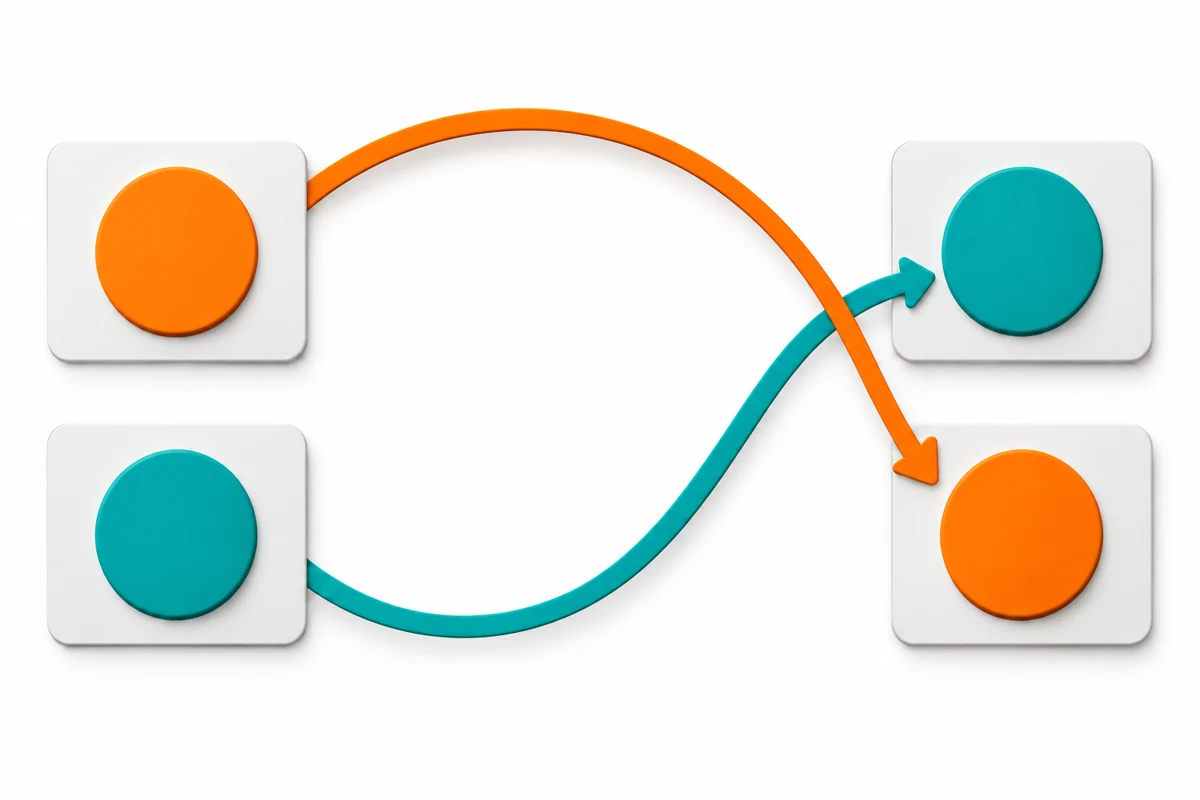
by group: [20.0, 10.0]to_numpy는 라벨을 버리고 위치로 넣습니다. 네 행에 값 두 개를 넣으면 길이 오류가 나지만, 우연히 그룹 수와 행 수가 같으면 오류 없이 다른 팀 평균을 넣을 수 있습니다. reset_index(drop=True)도 그룹별 결과를 원본 행별 결과로 바꾸지 않으므로 범용 해결책이 아닙니다.
행 개수가 맞는지만 확인하면 두 번째 반례를 놓칩니다. 같은 행 단위인지, 그 순서까지 일치하는지를 확인한 경우에만 라벨을 제거한 위치 대입을 선택하세요.
4. 이미 만든 그룹 요약은 그룹 키로 map합니다
mapped = df["team"].map(means)
print("mapped:", mapped.tolist())
print("same values:", mapped.equals(group_mean))
assert mapped.index.equals(df.index)

missing_key = pd.DataFrame({
    "team": ["A", None],
    "sales": [10, 30],
})
default = missing_key.groupby("team")["sales"].transform("mean")
included = missing_key.groupby("team", dropna=False)["sales"].transform("mean")
print("default missing:", default.isna().tolist())
print("include missing key:", included.tolist())
mapped: [30.0, 20.0, 30.0, 20.0]
same values: True
default missing: [False, True]
include missing key: [10.0, 30.0]map은 원본 team 값을 means의 그룹 키와 대응시킵니다. 이처럼 하나의 키로 요약한 Series를 다시 사용할 때 편합니다. 요약에 없는 키는 결측으로 나타나므로 모든 팀이 연결되는지도 확인하세요. 여러 키로 묶었다면 키 조합과 중복 제약을 확인한 merge 등 더 명시적인 연결이 필요합니다.
transform을 사용해도 NaN이 언제나 사라지는 것은 아닙니다. 기본 groupby는 결측 그룹 키를 제외하며, 값이 모두 결측인 그룹의 평균도 결측입니다. 위 예제의 dropna=False는 결측 키를 한 그룹으로 포함한다는 정책 선택입니다. 불필요하게 0으로 채우면 원인을 감출 수 있습니다.
적용 전 점검과 핵심 정리
그룹별 보고서가 필요하면 집계 결과를 그대로 사용하세요. 원본 각 행에 그룹 통계가 필요하면 transform, 이미 만든 단일 키 요약을 재사용하면 map을 검토합니다. 대입 전후 행 수·인덱스·대표 그룹의 값을 함께 대조하면 조용히 틀리는 배치를 찾기 쉽습니다.
그룹 자체가 누락되는 문제는 groupby의 dropna와 size·count 차이에서 따로 확인할 수 있습니다. 오늘 문제의 핵심은 계산한 통계의 정확성과 원본 행에 붙이는 정확성을 나누어 검사하는 것입니다.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| pandas pivot 중복 오류 해결: pivot_table로 바꾸기 전에 집계 기준 확인 (0) | 2026.10.16 |
|---|---|
| pandas to_numeric에서 NaN이 늘어날 때: 변환 실패 행과 원래 결측값 구분 (0) | 2026.10.15 |
| pandas crosstab 비율이 다르게 나올 때: 행·열·전체 분모와 빈 범주 (0) | 2026.10.14 |
| pandas explode에서 행이 늘어날 때: 빈 리스트·문자열·여러 열 길이 검증 (0) | 2026.10.13 |
| pandas merge_asof 정렬 오류 해결: 시간 키·tolerance·미래값 방지 (0) | 2026.10.12 |


댓글