고객 코드의 앞뒤 공백을 지운 뒤 중복이 생겼다면, 원본 열을 보존한 채 정리 전후의 대응을 먼저 검사하세요. " C001"과 "C001"은 원래 문자열은 다르지만 str.strip() 뒤에는 같은 키가 됩니다. 중복을 발견하자마자 한 행을 지우면 어느 원본이 합쳐졌는지 잃기 쉽습니다.
이 실습은 고객 코드당 기준 정보가 한 행이어야 하는 고객 기준표를 대상으로 합니다. 원래부터 같은 코드가 반복된 경우, 서로 다른 원본 표현이 하나의 정리된 키로 모인 경우, 결측·빈 값을 나누어 표시합니다. 거래표에서 한 고객이 여러 번 주문하는 정상 반복까지 금지하는 규칙은 아닙니다.
실행 확인: Python 3.12.14 · pandas 2.2.3. 아래 데이터는 직접 만든 소형 실습 데이터이며 실제 고객 정보가 아닙니다.
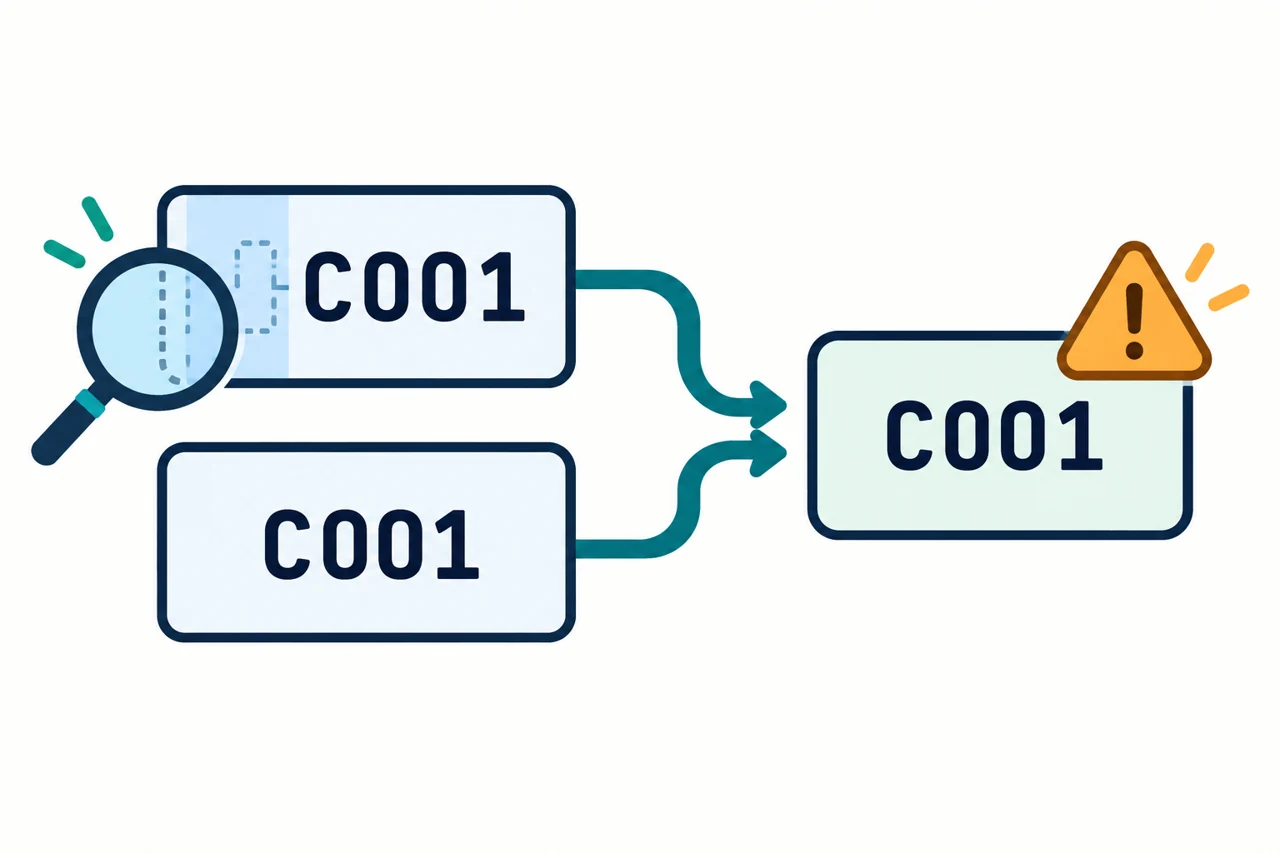
1. 중복 여부보다 먼저 원본과 정리된 키를 함께 남깁니다
raw는 받은 값 그대로, key는 앞뒤 공백만 제거한 값입니다. raw_duplicate는 유효한 원본 코드의 반복을, normalization_collision은 하나의 key에 서로 다른 raw 표현이 연결되는 상황을 뜻합니다. 두 표시는 같은 키에서 함께 참일 수 있습니다.
예를 들어 C002 두 행에 공백이 붙은 C002 한 행이 더 있으면 원래 중복과 정규화 충돌이 동시에 있습니다. 충돌을 발견했다는 것은 검토할 원본 대응이 있다는 뜻입니다. 실제로 서로 다른 고객인지, 같은 고객의 표기 차이인지는 별도 기준 정보로 판단해야 합니다.
2. 그대로 실행하는 충돌 감사 코드
아래를 key_audit.py로 저장하고 pandas가 설치된 환경에서 실행합니다. 숫자로 들어온 고객 코드는 문자열로 바꾸기 전에 중단합니다. 이미 숫자로 읽어 사라진 앞자리 0은 뒤늦은 문자열 변환으로 복원되지 않기 때문입니다.
"""Synthetic, in-memory example. Run in one Python session."""
import sys
import pandas as pd

def audit_codes(values):
    raw = pd.Series(values, dtype="object")
    non_string = raw.notna() & ~raw.map(lambda value: isinstance(value, str))
    if non_string.any():
        raise TypeError(f"non-string customer code rows: {raw.index[non_string].tolist()}")
    raw = raw.astype("string")
    key = raw.str.strip()
    missing = raw.isna()
    empty_input = raw.eq("").fillna(False)
    stripped_empty = raw.notna() & ~empty_input & key.eq("").fillna(False)
    usable = ~(missing | key.eq("").fillna(False))
    audit = pd.DataFrame({
        "raw": raw, "key": key, "missing": missing,
        "empty_input": empty_input, "stripped_empty": stripped_empty,
        "usable": usable,
    })
    valid = audit.loc[usable]
    variants = valid.groupby("key", sort=True)["raw"].nunique(dropna=False)
    collision_keys = variants[variants > 1].index.tolist()
    audit["raw_duplicate"] = False
    audit.loc[usable, "raw_duplicate"] = valid["raw"].duplicated(keep=False)
    audit["normalization_collision"] = audit["key"].isin(collision_keys)
    summary = {
        "missing_rows": audit.index[missing].tolist(),
        "empty_input_rows": audit.index[empty_input].tolist(),
        "stripped_empty_rows": audit.index[stripped_empty].tolist(),
        "raw_duplicate_rows": audit.index[audit["raw_duplicate"]].tolist(),
        "collision_keys": collision_keys,
        "normalized_duplicate_rows": valid.index[
            valid["key"].duplicated(keep=False)
        ].tolist(),
    }
    return audit, summary

def require_clean_master(values):
    audit, summary = audit_codes(values)
    if any(summary[name] for name in (
        "missing_rows", "empty_input_rows", "stripped_empty_rows",
        "raw_duplicate_rows", "collision_keys",
    )):
        raise ValueError(f"customer key audit failed: {summary}")
    return audit

raw_values = [
    " C001", "C001", "C002", "C002", " C002",
    None, "", "   ", "C003", "C004\t", "C004",
]
audit, summary = audit_codes(raw_values)
print("versions:", sys.version.split()[0], pd.__version__)
print("raw -> key:")
for row_id, row in audit.iterrows():
    print(row_id, repr(row["raw"]), "->", repr(row["key"]))
print("summary:", summary)
mapping = {
    key: [repr(value) for value in audit.loc[audit["key"].eq(key), "raw"].drop_duplicates()]
    for key in summary["collision_keys"]
}
print("collision mapping:", mapping)
assert summary == {
    "missing_rows": [5], "empty_input_rows": [6], "stripped_empty_rows": [7],
    "raw_duplicate_rows": [2, 3], "collision_keys": ["C001", "C002", "C004"],
    "normalized_duplicate_rows": [0, 1, 2, 3, 4, 9, 10],
}
try:
    require_clean_master(raw_values)
except ValueError as exc:
    print("merge not started:", type(exc).__name__)

clean = require_clean_master(["C001", "C002", "C003", "C004"])
master = clean[["key"]].assign(name=["A", "B", "C", "D"])
orders = pd.DataFrame({"order_id": [101, 102], "key": ["C001", "C004"]})
merged = orders.merge(master, on="key", how="left", validate="many_to_one")
print("clean merge:", merged[["order_id", "key", "name"]].values.tolist())
assert len(merged) == len(orders)
3. 기대 결과에서 세 종류의 문제를 구분합니다
원래 중복 행은 0부터 세는 인덱스 2·3입니다. 정규화 충돌 키는 C001·C002·C004 세 개이며, 정리된 키가 반복되는 행은 0·1·2·3·4·9·10입니다. 원래 중복과 충돌을 더해서 서로 다른 오류 개수라고 세면 겹치는 C002를 중복 집계하게 됩니다.
결측은 5번, 원래 빈 문자열은 6번, 공백 제거 후 빈 값이 된 행은 7번입니다. 셋 모두 기준표의 연결 키로 사용하지 않지만 원인은 따로 보존합니다. repr() 출력에서 \t 같은 문자를 보면 눈에 잘 안 보이는 뒤쪽 탭도 확인할 수 있습니다.
첫 기준표는 감사 실패로 병합을 시작하지 않습니다. 검토가 끝났다고 가정한 별도 기준표에서는 [[101, "C001", "A"], [102, "C004", "D"]]에 해당하는 두 주문이 연결됩니다. 예제의 깨끗한 기준표는 설명을 위해 직접 지정한 것이며, 원본을 자동으로 올바르게 고친 결과가 아닙니다.
4. 정리 규칙을 늘릴 때도 같은 검사를 다시 합니다
기본 strip은 앞뒤 공백 문자에 적용하며 내부 공백·대소문자·전각 문자·임의의 보이지 않는 문자까지 통일하는 기능은 아닙니다. 대문자 변환이나 Unicode 정규화를 추가한다면 각 단계마다 원본과 결과의 대응을 다시 검사하세요. 더 강하게 정리할수록 원래 다른 식별자가 같은 값으로 바뀔 수 있습니다.
문자열 NA를 결측으로 볼지, 빈 코드를 허용할지는 입력 계약에서 정합니다. CSV를 읽는 단계부터 값이 달라졌다면 read_csv에서 앞자리 0과 문자열 NA를 보존하는 방법을 먼저 확인하세요. 이미 손실된 원본 정보와 공백 정리 문제는 원인이 다릅니다.
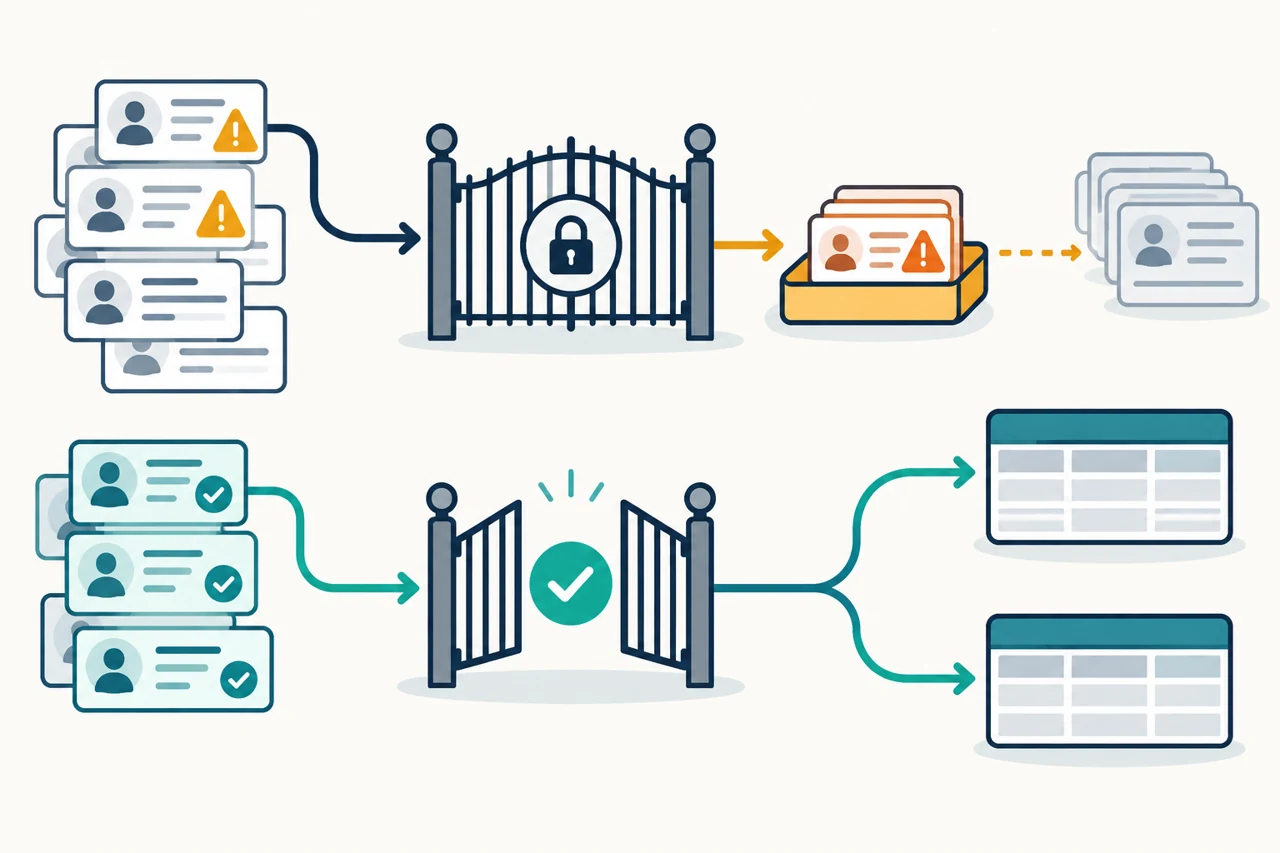
5. 병합에 넘기기 전 남길 기록
원본 파일 식별값, 원본 행 위치, 정리 규칙 버전, raw→key 대응, 충돌 목록과 사람이 선택한 처리 기준을 남깁니다. 임의로 첫 행을 선택하는 대신 실제 고객 기준에 맞게 수정하고 같은 감사를 다시 통과시킵니다. 필요하다면 원본의 고유 행 ID도 별도 열로 보존하세요.
감사를 통과한 뒤에는 merge의 validate와 미연결 행 검사로 연결 관계를 확인합니다. 오른쪽 키 유일성, 연결되지 않은 주문, 병합 뒤 주문 수·금액 보존은 각각 다른 조건입니다.
핵심 정리: 공백 정리는 값을 바꾸는 작업입니다. 원본을 덮어쓰기 전에 원래 중복·새 충돌·결측/빈 값을 구분하고, 고객 기준표의 유일성이 확인된 뒤 다음 병합을 시작하세요.
'언어별 개념 정리 > Python' 카테고리의 다른 글
| pandas 조건식의 pd.NA는 False일까? 미확정 행을 따로 남기는 방법 (0) | 2026.10.25 |
|---|---|
| Python json.loads에서 중복 키가 사라질 때: object_pairs_hook으로 입력 거부 (0) | 2026.10.25 |
| Python pathlib 상대경로 오류 해결: 실행 폴더와 __file__ 기준 분리 (0) | 2026.09.23 |
| Python sorted와 list.sort 차이: 반환값·원본 변경·key 사용·선택 기준 (0) | 2026.09.21 |
| Python pathlib의 resolve와 absolute는 무엇이 다를까? (0) | 2026.09.19 |


댓글