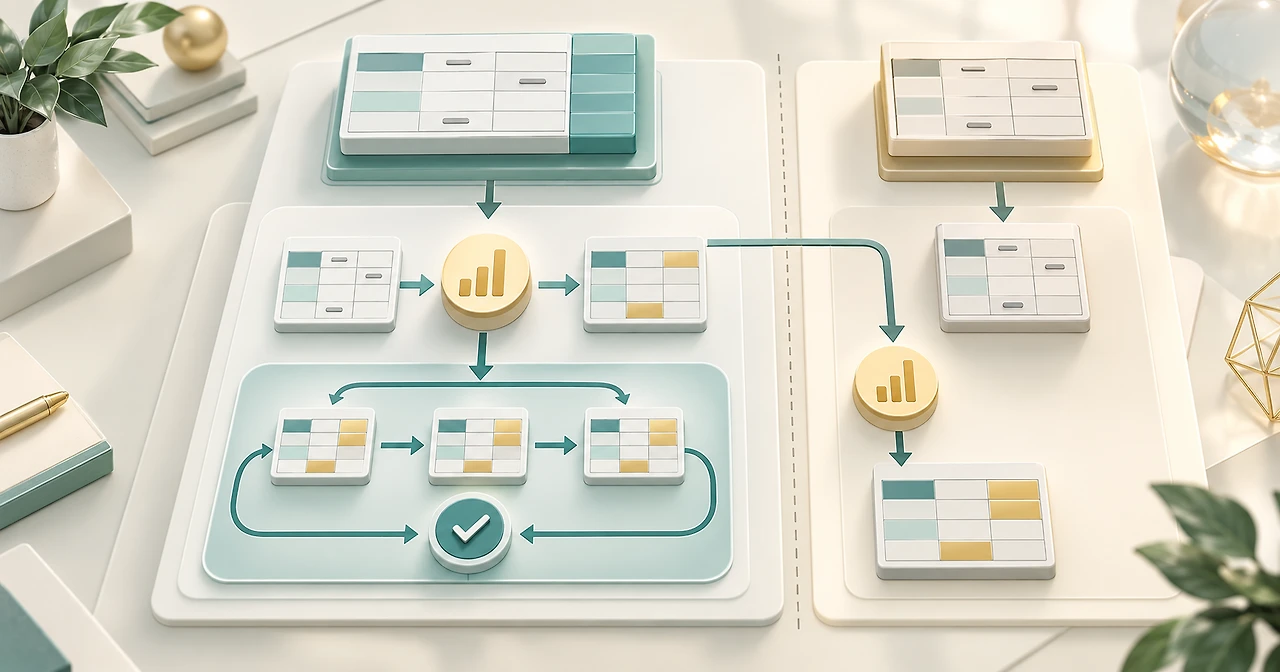
결측값을 평균으로 채운 뒤 데이터를 나누면 테스트 데이터의 정보가 학습 과정에 섞일 수 있습니다. 평균처럼 정답을 쓰지 않는 전처리도 데이터를 보고 기준을 정한다면 적용 순서가 중요합니다. 먼저 데이터를 나누고, 학습 데이터에서 구한 기준을 검증·테스트 데이터에 그대로 적용해야 합니다. 작은 배열로 평균이 어떻게 달라지는지 확인하고, 같은 규칙을 교차검증 안까지 이어 보겠습니다.
1. 평균 20이 40으로 바뀌는 순간을 찾습니다
학습 데이터는 [10, 20, 결측값, 30], 테스트 데이터는 [100, 결측값]이라고 가정합니다. 순서 차이만 보기 위한 가상 자료이며, 실제 시험 기출이나 모델 성능 자료는 아닙니다.
학습 데이터에서 관측된 값만 사용하면 대체 평균은 다음과 같습니다.
학습 평균 = (10 + 20 + 30) / 3 = 20
따라서 학습 데이터의 결측값도 20, 테스트 데이터의 결측값도 20으로 채웁니다. 테스트에 100이라는 값이 있어도 학습에서 정한 평균은 바꾸지 않습니다.
반대로 두 데이터를 먼저 합쳐 평균을 구하면 값이 달라집니다.
전체 평균 = (10 + 20 + 30 + 100) / 4 = 40
이렇게 구한 40으로 학습 데이터의 빈칸을 채웠다면, 학습 단계가 원래 보지 않아야 할 테스트 분포의 영향을 받은 것입니다. 테스트의 정답을 사용하지 않았다는 이유만으로 누수가 없다고 판단할 수는 없습니다.
여기서 확인한 것은 전처리 기준의 오염입니다. 누수가 생기면 모든 데이터에서 평가 점수가 반드시 올라간다는 뜻은 아닙니다. 점수 변화의 방향과 별개로 평가 데이터를 학습 기준 결정에 사용했다는 문제가 남습니다.
2. fit은 기준을 배우고 transform은 그 기준을 적용합니다
평균 대체기에서 fit은 열마다 대체할 평균을 구합니다. transform은 이미 구해 둔 값을 사용해 결측값을 바꿉니다. fit_transform은 현재 입력으로 기준을 학습한 뒤 변환까지 수행합니다.
따라서 학습 데이터에는 fit_transform, 테스트 데이터에는 transform을 사용합니다. 아래 코드는 NumPy와 scikit-learn을 사용할 수 있는 환경에서 실행할 수 있습니다.
import numpy as np
from sklearn.impute import SimpleImputer

train = np.array([[10.], [20.], [np.nan], [30.]])
test = np.array([[100.], [np.nan]])

imputer = SimpleImputer(strategy="mean")
train_ready = imputer.fit_transform(train)
test_ready = imputer.transform(test)

print(imputer.statistics_)
print(train_ready.ravel())
print(test_ready.ravel())

np.testing.assert_allclose(imputer.statistics_, [20.])
np.testing.assert_allclose(
    train_ready.ravel(), [10., 20., 20., 30.]
)
np.testing.assert_allclose(test_ready.ravel(), [100., 20.])
출력은 다음과 같습니다.
[20.]
[10. 20. 20. 30.]
[100.  20.]
statistics_의 20은 학습 데이터에서 구한 대체값입니다. 테스트의 원래 값 100은 그대로 두고 결측값만 20으로 채웠습니다. 마지막 검사문은 출력 모양이 아니라 실제 배열 값을 비교합니다.
테스트 데이터에 다시 fit_transform을 호출하는 것도 해결책은 아닙니다. 이 사례에서는 테스트에서 관측된 값이 100 하나이므로 새 대체값이 100이 됩니다. 학습 때와 다른 규칙을 테스트에 적용하게 되며, 같은 대체기를 다시 학습시키면 보관 중인 statistics_도 달라집니다.
이 글에서는 평균 대체만 다루지만, 데이터에서 기준을 학습하는 스케일링이나 변수 선택에도 학습·적용의 구분이 필요합니다. 다만 행별로 고정된 단위를 바꾸는 연산까지 모두 같은 종류의 학습이라고 묶지는 않습니다.
3. 교차검증에서는 각 학습 폴드가 다시 기준이 됩니다
학습·테스트를 한 번 나누었다고 모든 누수가 사라지는 것은 아닙니다. 학습 데이터 전체를 평균 대체한 뒤 그 결과로 교차검증하면, 각 검증 폴드의 값이 이미 대체 평균에 포함될 수 있습니다.
교차검증의 한 회차에서는 학습 폴드로만 평균을 구하고 그 평균으로 해당 검증 폴드를 변환해야 합니다. 다음 회차에서는 학습 폴드가 바뀌므로 평균을 새로 구합니다.
여섯 행의 입력 [10, 결측값, 20, 30, 40, 결측값]을 순서대로 세 폴드로 나누어 보겠습니다. 행 번호는 0부터 시작합니다.
검증 행 0·1: 학습의 관측값은 20, 30, 40 → 평균 30
검증 행 2·3: 학습의 관측값은 10, 40 → 평균 25
검증 행 4·5: 학습의 관측값은 10, 20, 30 → 평균 20
전체 관측값의 평균 25를 모든 회차에 미리 적용하면, 첫째와 셋째 회차는 자신의 학습 폴드만으로 구한 평균과 달라집니다. 전처리를 먼저 끝내 놓고 검증을 나중에 붙이는 순서가 문제입니다.
4. Pipeline을 통째로 교차검증에 전달합니다
전처리와 모델을 Pipeline에 묶고, 변환이 끝난 배열이 아니라 이 Pipeline 자체를 cross_validate에 전달합니다. 그러면 회차마다 복제된 Pipeline이 해당 학습 폴드로 대체기와 모델을 학습합니다.
다음 예제의 Ridge는 전처리와 모델을 함께 학습시키는 흐름을 보여 주기 위한 간단한 회귀 모델입니다. 성능을 비교하려는 예제가 아니므로 점수 대신 각 대체기가 배운 평균을 출력합니다.
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.linear_model import Ridge
from sklearn.model_selection import KFold, cross_validate

X = np.array([[10.], [np.nan], [20.],
              [30.], [40.], [np.nan]])
y = np.array([1., 2., 2., 3., 4., 5.])

pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="mean")),
    ("model", Ridge(alpha=1.0)),
])
cv = KFold(n_splits=3, shuffle=False)
result = cross_validate(
    pipeline, X, y, cv=cv,
    scoring="neg_mean_absolute_error",
    return_estimator=True,
    error_score="raise",
)
means = [
    float(estimator.named_steps["imputer"].statistics_[0])
    for estimator in result["estimator"]
]
print(means)
np.testing.assert_allclose(means, [30., 25., 20.])
출력은 [30.0, 25.0, 20.0]입니다. 손으로 나눈 세 회차의 평균과 일치합니다. return_estimator=True로 받은 회차별 Pipeline 안에서 imputer의 statistics_를 읽었습니다.
KFold의 shuffle=False는 이 작은 예제의 분할을 눈으로 따라가기 위한 선택입니다. 시간 순서가 중요한 데이터나 같은 사람의 여러 행이 있는 데이터에 이 설정을 그대로 권하는 것은 아닙니다. 실제 문제에서는 예측 시점과 개체 중복을 고려해 분할 방법부터 정해야 합니다.
cross_validate가 평가한 회차별 추정기와 처음 만든 pipeline 변수도 구분해야 합니다. 새 데이터를 예측할 최종 모델이 필요하면 모델·설정을 선택한 뒤 학습용 데이터로 최종 Pipeline을 따로 학습합니다. 최종 테스트는 그 선택을 평가하는 용도로 남깁니다.
5. Pipeline으로 해결되는 범위와 남는 점검을 나눕니다
Pipeline은 안에 넣은 전처리와 모델의 학습 순서를 관리합니다. 하지만 Pipeline 바깥에서 전체 데이터로 평균 대체나 변수 선택을 끝내 놓았다면 그 누수를 되돌려 주지는 않습니다.
정답을 직접 담은 입력 열, 예측 시점 이후에만 알 수 있는 값, 학습·검증 양쪽에 섞인 같은 개체의 기록도 별도 문제입니다. Pipeline을 사용했다는 사실 하나만으로 데이터 분할과 입력 변수가 모두 적절하다고 결론 내릴 수는 없습니다.
평균 대체가 해당 열에 적절한지도 남습니다. 극단값의 영향, 범주형 자료의 처리, 학습 폴드에서 관측값이 하나도 없는 열은 따로 검토해야 합니다. 이 예제는 모든 학습 폴드에 적어도 하나의 관측값이 있는 수치 열로 범위를 제한했습니다.
점검할 때는 ‘데이터를 어디서 나누었는가’, ‘각 fit이 어떤 행을 보았는가’, ‘검증·테스트에는 transform만 적용했는가’를 순서대로 따라가면 됩니다. 실제 예측 시점에 얻을 수 없는 정보를 쓰고 있지 않은지도 함께 살펴야 합니다.
핵심 요약
평균 대체는 관측값으로 기준을 학습하는 전처리입니다. 학습·테스트를 합쳐 평균을 구하면 테스트의 정보가 학습에 섞일 수 있습니다.
교차검증에서는 매 회차의 학습 폴드로 대체값을 구해야 합니다. 전처리와 모델을 Pipeline에 묶고 Pipeline 전체를 검증에 전달하세요.
Pipeline은 잘못된 입력 변수나 데이터 분할까지 자동으로 고치지 않습니다. 전처리의 학습 범위와 실제 예측에서 사용할 정보의 범위를 각각 점검해야 합니다.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| pandas read_csv: 앞자리 0과 문자열 NA를 보존하는 방법 (0) | 2026.10.03 |
|---|---|
| 빅데이터분석기사 분산 계산 실습: NumPy와 pandas의 ddof 맞추기 (1) | 2026.10.02 |
| 빅데이터분석기사 필기 혼동행렬 계산 실습: 정밀도·재현율·F1과 지표 선택 (0) | 2026.09.29 |
| 빅분기 실기 연습 모음집: 1·2·3유형 문제와 CSV·노트북 (0) | 2026.09.15 |
| 빅분기 실기 작업형 3유형 연습문제 8제: CSV와 주피터 노트북 (0) | 2026.09.15 |


댓글