CSV 헤더가 세 열인데 어떤 행은 네 값이고 어떤 행은 두 값이어도 csv.DictReader가 자동으로 파일 전체를 거부하지는 않습니다. 추가 필드는 restkey로 모이고 부족한 필드는 restval로 채워지므로, 입력을 쓰기 전에 헤더 계약과 각 레코드의 구조를 직접 검사해야 합니다.
특히 a,b,처럼 마지막 셀이 빈 문자열인 경우와 a,b처럼 마지막 필드 자체가 없는 경우는 다릅니다. 아래 실습은 이 둘을 구분하고, 추가 쉼표·따옴표 안의 쉼표·여러 줄 필드를 같은 파일에서 확인합니다. 실제 고객 파일이나 데이터베이스에 쓰지 않고 메모리의 합성 CSV만 읽습니다.
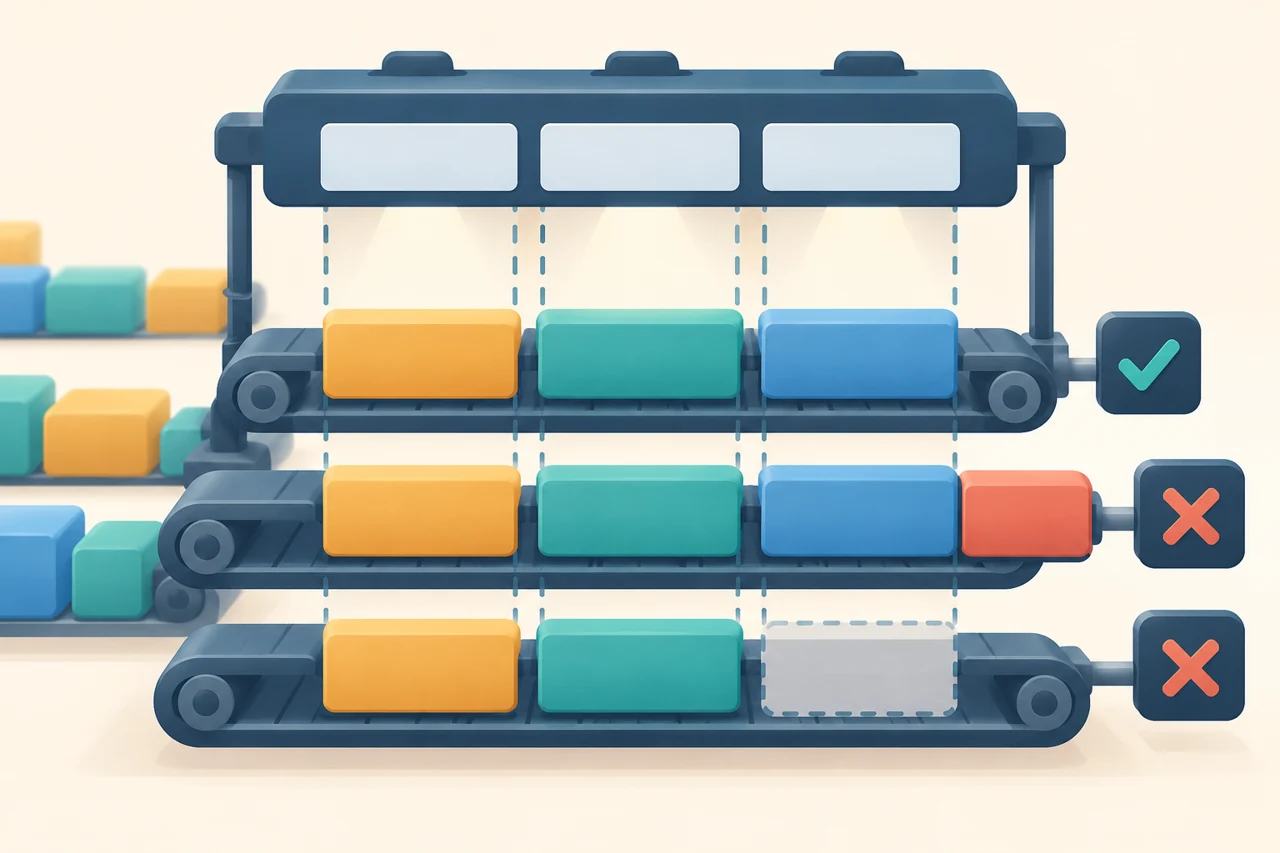
strict=True는 열 수 검증 옵션이 아닙니다
csv 모듈의 strict=True는 파서가 잘못된 CSV 입력으로 판단한 경우 csv.Error를 발생시키도록 합니다. 헤더와 데이터의 필드 수가 같은지까지 검사하는 업무 스키마 옵션은 아닙니다. 문법상 읽힌 레코드에도 추가 필드나 누락 필드가 있을 수 있습니다.
DictReader의 기본 restkey와 restval은 모두 None입니다. 기본 설정에 기대어 결과 dict만 저장하면 정상 빈 문자열과 누락된 값을 구분하는 계약이 흐려질 수 있습니다. 예제에서는 추가 필드용 고유 키를 정하고 누락 값에는 object()로 만든 별도의 표식을 사용합니다.
먼저 헤더를 확정한 뒤 레코드를 검사합니다
예상 헤더는 id,name,amount이며 순서까지 같아야 통과하게 했습니다. 헤더가 중복됐거나 추가 필드용 키와 충돌하는 입력도 이 단계에서 막습니다. 헤더 이름이 틀렸는데 fieldnames를 강제로 덮어쓰면 첫 줄이 데이터로 처리될 수 있으므로, 원래 헤더를 읽고 대조합니다.
CSV의 한 레코드는 물리적인 한 줄과 같지 않을 수 있습니다. 따옴표 안의 개행은 필드 내부의 내용입니다. 단순 split(",")나 줄 수만으로 레코드를 세지 않습니다. 실제 파일은 open(path, encoding="utf-8", newline="")처럼 열고 이 reader에 넘기세요. BOM이 있는 파일을 받는 계약이라면 utf-8-sig 같은 명시적인 처리도 별도로 정합니다.
추가·누락·빈 셀을 한 파일에서 재현합니다
Python 3.14.7 표준 라이브러리로 실행했습니다. csv_shape_demo.py로 저장해 python3 csv_shape_demo.py로 실행하세요. 반환된 accepted는 필드 수 검사를 통과한 레코드이지 금액·필수값 같은 업무 검증까지 끝난 레코드는 아닙니다.
import csv
import io

DATA = ('id,name,amount\n'
        '001,"홍,길동",10\n'
        '002,김,20,EXTRA\n'
        '003,박\n'
        '004,최,\n'
        '005,"두 줄\n이름",30\n'
        '006,윤,40,\n')
EXPECTED = ['id', 'name', 'amount']
EXTRA_KEY = '__extra_fields__'
MISSING = object()

def inspect(text):
    reader = csv.DictReader(io.StringIO(text, newline=''),
                            restkey=EXTRA_KEY, restval=MISSING, strict=True)
    if reader.fieldnames != EXPECTED:
        raise ValueError('header does not match expected schema')
    accepted, rejected = [], []
    for record_number, row in enumerate(reader, start=1):
        reasons = []
        if EXTRA_KEY in row:
            reasons.append('extra fields=' + repr(row[EXTRA_KEY]))
        absent = [key for key in EXPECTED if row[key] is MISSING]
        if absent:
            reasons.append('missing fields=' + repr(absent))
        location = (record_number, reader.line_num)
        if reasons:
            rejected.append((location, reasons))
            print('REJECT', location, '; '.join(reasons))
        else:
            accepted.append((location, row))
            print('ACCEPT', location, repr(row))
    return accepted, rejected

if __name__ == '__main__':
    accepted, rejected = inspect(DATA)
    assert [row['id'] for _, row in accepted] == ['001', '004', '005']
    assert accepted[1][1]['amount'] == ''  # Present, but empty; not MISSING.
    assert [where for where, _ in accepted] == [(1, 2), (4, 5), (5, 7)]
    assert len(rejected) == 3
    try:
        inspect('id,name,name\n001,A,B\n')
    except ValueError:
        print('bad header: REJECTED')
실제 출력에서 확인할 세 가지
ACCEPT (1, 2) {'id': '001', 'name': '홍,길동', 'amount': '10'}
REJECT (2, 3) extra fields=['EXTRA']
REJECT (3, 4) missing fields=['amount']
ACCEPT (4, 5) {'id': '004', 'name': '최', 'amount': ''}
ACCEPT (5, 7) {'id': '005', 'name': '두 줄\n이름', 'amount': '30'}
REJECT (6, 8) extra fields=['']
bad header: REJECTED
첫 번째 괄호는 (데이터 레코드 번호, 해당 레코드를 읽은 뒤의 reader.line_num)입니다. id=005의 이름은 두 물리줄에 걸쳐 있어서 다섯 번째 데이터 레코드의 끝 줄은 7입니다. line_num은 CSV 소스에서 읽은 줄 수이며 항상 레코드 번호와 같지 않습니다.
id=003은 amount 필드가 없어서 거부됩니다. id=004는 amount 자리가 있으며 값이 빈 문자열이라 구조 검사에는 통과합니다. 이 값이 업무상 허용되는지는 다음 필수값·숫자 검증에서 결정합니다. id=006의 끝 쉼표는 추가 빈 필드 하나를 만들므로 extra fields=['']로 거부됩니다.
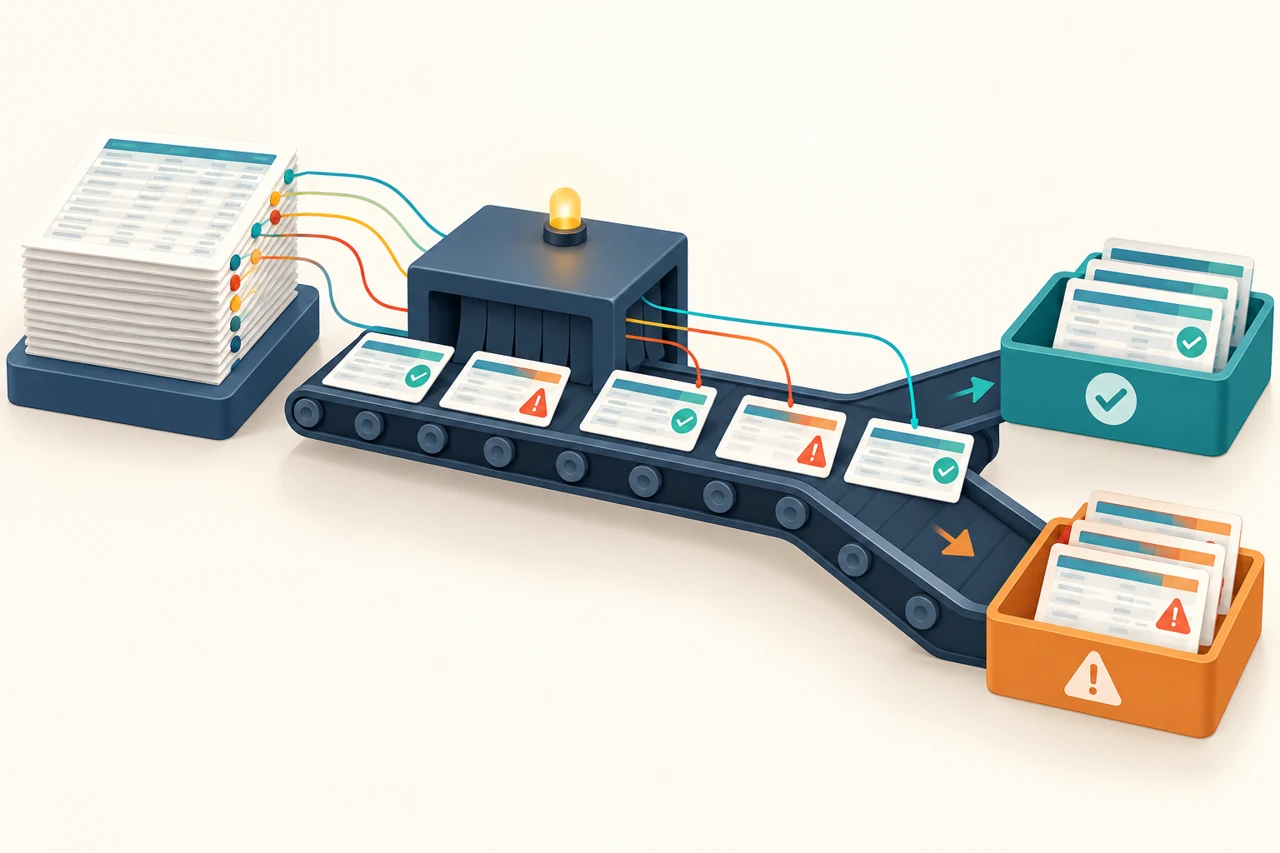
검사 결과를 남기되 일부 행을 조용히 저장하지 않습니다
이 예제는 위치와 거부 사유를 출력하고 수집할 뿐, 원본 파일을 저장하거나 DB에 적재하는 프로그램은 아닙니다. 실제 배치에서는 원본 파일을 별도 보존하고 파일 식별자·레코드 위치·검사 버전·사유를 연결하세요. 민감한 필드 전체를 일반 로그에 남기기보다 필요한 식별 정보만 쓰는 정책이 필요합니다.
빈 물리줄은 DictReader가 건너뛸 수 있고, 잘못된 따옴표 등 파서 오류는 이 구조 검사를 마치기 전에 발생할 수 있습니다. 전체 파일이 검증된 뒤 한 번에 반영할지, 허용·거부 레코드를 별도로 처리할지도 명시해야 합니다. 앞에서 ACCEPT가 출력됐다는 사실은 파일 전체가 정상이라는 영수증이 아닙니다.
구조 검사 다음에 pandas CSV의 앞자리 0과 문자열 NA 보존을 이어서 확인할 수 있습니다. 이번 코드의 id는 문자열로 남지만, 다른 도구로 다시 읽으면 자료형·결측 추론이 바뀔 수 있습니다.
핵심 정리
CSV 파싱 성공, 필드 수 일치, 값의 의미 검증을 따로 확인하세요. 헤더를 먼저 대조하고 추가 필드·누락 표식·정상 빈 문자열을 구분하면 입력 변화가 조용히 데이터로 섞이는 일을 줄일 수 있습니다.
'언어별 개념 정리 > Python' 카테고리의 다른 글
| Python Queue.join()이 끝났는데 작업은 실패했을 때: task_done과 결과 분리 (0) | 2026.10.28 |
|---|---|
| pandas 조건식의 pd.NA는 False일까? 미확정 행을 따로 남기는 방법 (0) | 2026.10.25 |
| Python json.loads에서 중복 키가 사라질 때: object_pairs_hook으로 입력 거부 (0) | 2026.10.25 |
| pandas 공백 제거 후 중복 키가 생길 때: 원본과 정규화 충돌 검사 (0) | 2026.10.21 |
| Python pathlib 상대경로 오류 해결: 실행 폴더와 __file__ 기준 분리 (0) | 2026.09.23 |


댓글