날짜 열을 변환한 뒤 NaT가 늘었다면, 곧바로 행을 삭제하기 전에 원본을 확인하세요. 입력이 비어 있었던 행과 형식·날짜가 맞지 않아 변환에 실패한 행은 원인이 다릅니다. format을 명시하고 원본 열을 보존하면 두 상황을 분리해 점검할 수 있습니다.
아래 예제는 Python 3.12.14·pandas 2.2.3에서 확인했습니다. 파일 없이 실행할 수 있는 가상 자료이며, 날짜만 다룹니다.
1. 같은 NaT여도 원인은 다릅니다
import pandas as pd

raw = pd.Series([
    "2026-10-01", "2026-02-30", "2026-10-03",
    None, "2026/10/04", " "
], name="date_raw")

clean = raw.astype("string").str.strip().replace("", pd.NA)
parsed = pd.to_datetime(
    clean, format="%Y-%m-%d", errors="coerce"
)
print(parsed.dt.strftime("%Y-%m-%d").fillna("NaT").tolist())
실행 결과는 다음과 같습니다.
['2026-10-01', 'NaT', '2026-10-03', 'NaT', 'NaT', 'NaT']2026-02-30은 실제 달력에 없는 날짜입니다. 2026/10/04는 이 예제에서 지정한 하이픈 형식과 다릅니다. None과 공백만 있는 값은 정리한 뒤 입력 누락으로 분류합니다.
errors="coerce"는 변환 실패를 NaT로 표시할 뿐, 잘못된 날짜를 올바른 날짜로 복구하지 않습니다. 오류를 즉시 중단해야 하는 작업이라면 기본값인 errors="raise"를 선택합니다.
2. 원본을 남기고 누락·변환 실패를 나눕니다
missing_input = clean.isna()
parse_failure = clean.notna() & parsed.isna()

audit = pd.DataFrame({
    "raw": raw,
    "clean": clean,
    "parsed": parsed,
    "missing_input": missing_input,
    "parse_failure": parse_failure,
})

print("입력 누락:", audit.index[missing_input].tolist())
print("변환 실패:", audit.index[parse_failure].tolist())
print(audit.loc[parse_failure, "raw"].tolist())
입력 누락: [3, 5]
변환 실패: [1, 4]
['2026-02-30', '2026/10/04']이 예제의 행 번호는 0부터 시작합니다. 원본을 바로 덮어썼다면 두 오류가 모두 NaT로 남아 구분이 어려워집니다. 실제 자료에서는 원본 행 번호와 식별자도 함께 보관하면 수정할 대상을 찾기 쉽습니다.
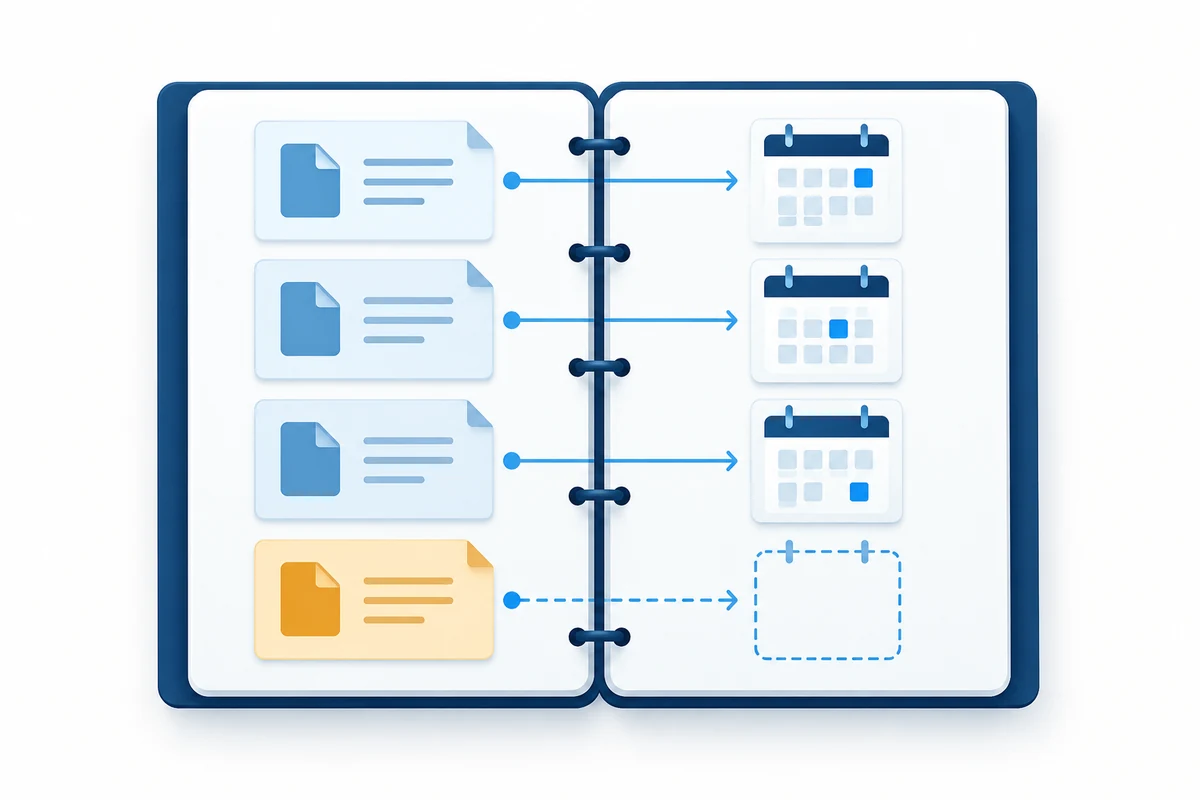
입력 누락을 자동으로 오늘 날짜로 채우는 처리는 피하세요. 어떤 날짜가 빠졌는지 모르는 상태에서 임의의 날짜를 넣으면 기간 집계와 시계열 순서까지 달라질 수 있습니다.
3. 혼합 형식은 확인된 규칙으로 나눠 변환합니다
mixed = pd.Series([
    "2026-10-01", "2026/10/02", "01/02/2026"
], dtype="string")
converted = pd.Series(pd.NaT, index=mixed.index, dtype="datetime64[ns]")

rules = [
    (r"\d{4}-\d{2}-\d{2}", "%Y-%m-%d"),
    (r"\d{4}/\d{2}/\d{2}", "%Y/%m/%d"),
]
for pattern, fmt in rules:
    mask = mixed.str.fullmatch(pattern, na=False)
    converted.loc[mask] = pd.to_datetime(
        mixed.loc[mask], format=fmt, errors="coerce"
    )

print(converted.dt.strftime("%Y-%m-%d").fillna("NaT").tolist())
print(mixed.loc[converted.isna()].tolist())
['2026-10-01', '2026-10-02', 'NaT']
['01/02/2026']01/02/2026은 1월 2일인지 2월 1일인지 수집 규칙이 필요합니다. 이 예제는 연·월·일 순서의 두 형식만 허용하므로 모호한 값을 별도로 남깁니다. 지원할 형식을 늘릴 때도 원자료의 정의를 먼저 확인하세요.
format="mixed"는 값마다 형식을 추론하는 선택지지만, 모호한 날짜의 의미를 보장하지 않습니다. dayfirst=True 역시 엄격한 형식 검증 규칙으로 쓰면 안 됩니다. 정해진 입력 규격이 있다면 형식을 명시하고, 자리수·구분자까지 엄격히 검사할 때는 별도 패턴 확인을 함께 사용합니다.
4. 변환 뒤 행 수와 실패 건수를 검증합니다
assert len(parsed) == len(raw)
assert int(parsed.notna().sum()) == 2
assert int(missing_input.sum()) == 2
assert int(parse_failure.sum()) == 2
assert int(parsed.isna().sum()) == int(missing_input.sum() + parse_failure.sum())
print("검증 통과")
첫 자료에서는 유효 날짜 2개·입력 누락 2개·변환 실패 2개이며 원본 6행을 유지합니다. 실패 행을 제외한다면 제외 전후의 행 수와 기간 분포도 비교해야 합니다.
숫자로 저장한 Unix 시각은 unit과 기준 시점이 필요합니다. 시간대가 섞인 시각과 날짜만 있는 자료도 별도 문제입니다. 이 예제의 날짜 형식 규칙을 숫자 시각이나 시간대 변환에 그대로 적용하지 마세요.
5. 핵심 정리
원본 보존 → 공백·누락 정리 → 확인한 형식으로 변환 → 누락과 실패 분리 → 건수 검증 순서로 점검합니다. NaT를 없애는 것보다 NaT가 생긴 이유를 설명할 수 있는 상태를 만드는 것이 먼저입니다.
결측값 처리의 전체 흐름은 데이터 전처리 정리에서, CSV를 읽을 때 원본 문자열이 바뀌는 문제는 read_csv의 식별자·NA 보존 실습에서 이어서 확인할 수 있습니다.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| pandas groupby에 없는 조합이 생길 때: observed와 범주형 집계 (0) | 2026.10.08 |
|---|---|
| pandas 정수 변환 오류 해결: int64·Int64와 결측값·소수 검사 (0) | 2026.10.07 |
| pandas groupby에서 행이 사라질 때: dropna=False와 size·count 구분 (0) | 2026.10.04 |
| pandas read_csv: 앞자리 0과 문자열 NA를 보존하는 방법 (0) | 2026.10.03 |
| 빅데이터분석기사 분산 계산 실습: NumPy와 pandas의 ddof 맞추기 (1) | 2026.10.02 |


댓글