astype("int64")에서 결측값 오류가 나면, 누락을 0으로 바꾸기 전에 열의 의미부터 확인하세요. 정수와 결측값을 함께 유지하려면 대문자 I로 시작하는 Int64를 명시할 수 있습니다. 다만 문자 오류나 소수까지 자동으로 고치는 자료형은 아닙니다.
Python 3.12.14·pandas 2.2.3에서 검증한 가상 수량 자료입니다. 파일 없이 실행하며, 작은 유한 수치와 정수 범위 안의 값만 다룹니다.
1. int64와 Int64를 구분합니다
import pandas as pd

s = pd.Series([10, None, 20])
print(s.dtype)
try:
    s.astype("int64")
except pd.errors.IntCastingNaNError as exc:
    print(type(exc).__name__)

nullable = pd.Series([10, None, 20], dtype="Int64")
print(nullable.tolist())
print(nullable.dtype)
float64
IntCastingNaNError
[10, <NA>, 20]
Int64이 예제의 기본 Series는 None 때문에 float64로 추론됩니다. 일반 int64는 이 결측 표현을 그대로 보관할 수 없어 변환이 실패합니다. 반면 명시적으로 만든 Int64 열은 누락을 pd.NA로 보존합니다.
자료형 문자열은 대소문자를 구분합니다. Int64는 결측 허용 정수이고, int64와 같은 표기가 아닙니다. 배열·Series·다른 입력의 추론 결과를 외우기보다 필요한 자료형을 명시하고 dtype를 확인하세요.
2. Int64로 바꿔도 소수 문제는 남습니다
try:
    pd.Series([10.0, None, 3.5]).astype("Int64")
except TypeError as exc:
print(type(exc).__name__)TypeError3.5는 정수로 정확히 표현할 수 없습니다. 이 변환은 소수를 자동으로 반올림하지 않습니다. 수량이 정수여야 하는 업무라면 소수 행을 오류로 분리하고, 소수가 정상인 측정값이라면 소수를 보존할 자료형을 선택해야 합니다.
오류를 없애기 위해 모든 값을 0으로 채우거나 정수 부분만 남기면 ‘수량 없음’, ‘실제 수량 0’, ‘소수 입력’을 섞게 됩니다. 반올림·버림이 업무 규칙이라면 적용 이유와 전후 값을 먼저 기록하세요.
3. 원본을 보존하고 세 가지 원인을 나눕니다
raw = pd.Series(["10", "", "20", "3.5", "oops", None],
                dtype="string")
clean = raw.str.strip().replace("", pd.NA)
number = pd.to_numeric(clean, errors="coerce")

missing_input = clean.isna()
parse_failure = clean.notna() & number.isna()
fractional = (number.notna() & number.mod(1).ne(0)).fillna(False)

result = number.mask(fractional).astype("Int64")
audit = pd.DataFrame({
    "raw": raw, "number": number, "result": result,
    "missing_input": missing_input,
    "parse_failure": parse_failure,
    "fractional": fractional,
})
print(result.tolist())
print("입력 누락:", audit.index[missing_input].tolist())
print("문자 변환 실패:", audit.index[parse_failure].tolist())
print("소수 검토:", audit.index[fractional].tolist())
[10, <NA>, 20, <NA>, <NA>, <NA>]
입력 누락: [1, 5]
문자 변환 실패: [4]
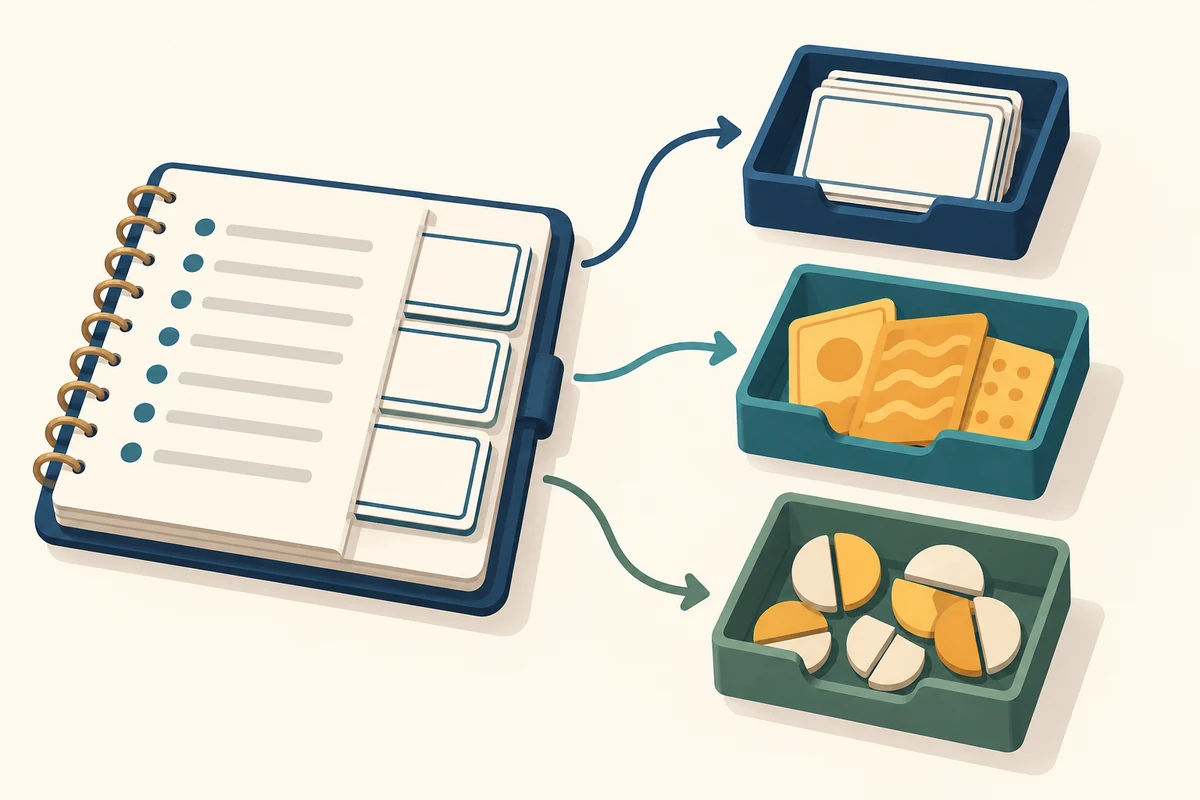
소수 검토: [3]행 번호는 0부터 시작합니다. 빈 문자열과 None은 입력 누락, oops는 숫자로 읽을 수 없는 문자, 3.5는 숫자로 읽혔지만 정수 조건을 충족하지 않는 값입니다. 결과 열에서 모두 <NA>로 보이더라도 검토 기록에서는 이유를 나눕니다.
errors="coerce"는 읽지 못한 값을 결측으로 표시합니다. 실패한 문자를 정상 수량으로 복구하지는 않습니다. 이 예제는 소수 행도 검토 대상으로 남기기 위해 결과 열에서 마스킹하며, 원본과 중간 숫자 열은 따로 보관합니다.
4. 변환 결과와 제외 이유의 건수를 검산합니다
valid = result.notna()
assert len(result) == len(raw) == 6
assert str(result.dtype) == "Int64"
assert int(valid.sum()) == 2
assert int(missing_input.sum()) == 2
assert int(parse_failure.sum()) == 1
assert int(fractional.sum()) == 1
assert int(valid.sum() + missing_input.sum()
           + parse_failure.sum() + fractional.sum()) == len(raw)
assert result.dropna().tolist() == [10, 20]
print("검증 통과")
원본 6행은 유효 정수 2행·입력 누락 2행·문자 오류 1행·소수 검토 1행으로 나뉩니다. 변환 후 행을 삭제하지 않았고, 유효 값 10과 20도 유지했습니다. 실제 자료에서는 식별자와 입력 위치를 함께 남겨 수정 대상을 찾으세요.
이 분류가 항상 모든 자료에 충분한 것은 아닙니다. 무한대, 64비트 정수 범위를 벗어나는 값, 매우 큰 숫자 문자열의 정밀도, 통화·천 단위 구분자 등은 추가 규칙이 필요합니다. 이 예제의 작은 유한 수치 검사만으로 그런 입력까지 검증됐다고 판단하면 안 됩니다.
5. 핵심 정리
자료형 선택과 값 검증을 함께 수행합니다. 결측을 보존하는 Int64를 명시하되 원본을 남기고 누락·문자 오류·소수를 분리합니다. 마지막에는 자료형, 행 수, 유효 값과 검토 건수를 확인하세요.
앞자리 0이 있는 식별자는 수량과 다르므로 숫자로 바꾸기 전에 CSV에서 식별자와 NA 문자열을 보존하는 방법을 확인하세요. 결측 처리의 전체 흐름은 데이터 전처리 정리와 연결됩니다.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| pandas groupby에 없는 조합이 생길 때: observed와 범주형 집계 (0) | 2026.10.08 |
|---|---|
| pandas 날짜 변환 오류 찾기: to_datetime·NaT와 원본값 검사 (0) | 2026.10.06 |
| pandas groupby에서 행이 사라질 때: dropna=False와 size·count 구분 (0) | 2026.10.04 |
| pandas read_csv: 앞자리 0과 문자열 NA를 보존하는 방법 (0) | 2026.10.03 |
| 빅데이터분석기사 분산 계산 실습: NumPy와 pandas의 ddof 맞추기 (1) | 2026.10.02 |


댓글