집계 결과에 원본에 없던 지역·채널 조합이 생기면 그룹 키가 범주형인지 확인하고 observed를 명시하세요. observed=True는 관측된 범주형 조합만 남기고, False는 사용하지 않은 범주 조합까지 집계 결과에 포함할 수 있습니다.
Python 3.12.14·pandas 2.2.3에서 실행한 파일 없는 예제입니다. pandas 3.0부터는 observed의 기본값이 True로 바뀌었으므로, 다른 버전에서 같은 보고서를 재현하려면 기본값에 기대지 않는 편이 좋습니다.
1. 값 세 개와 범주 목록을 구분합니다
import pandas as pd

df = pd.DataFrame({
    "region": pd.Categorical(
        ["Seoul", "Seoul", "Busan"],
        categories=["Seoul", "Busan", "Jeju"]
    ),
    "channel": pd.Categorical(
        ["web", "app", "web"],
        categories=["web", "app"]
    ),
    "sales": [10, 20, 30]
})
print(df.to_string(index=False))
print(df["region"].dtype, df["channel"].dtype)
region channel sales
Seoul web 10
Seoul app 20
Busan web 30
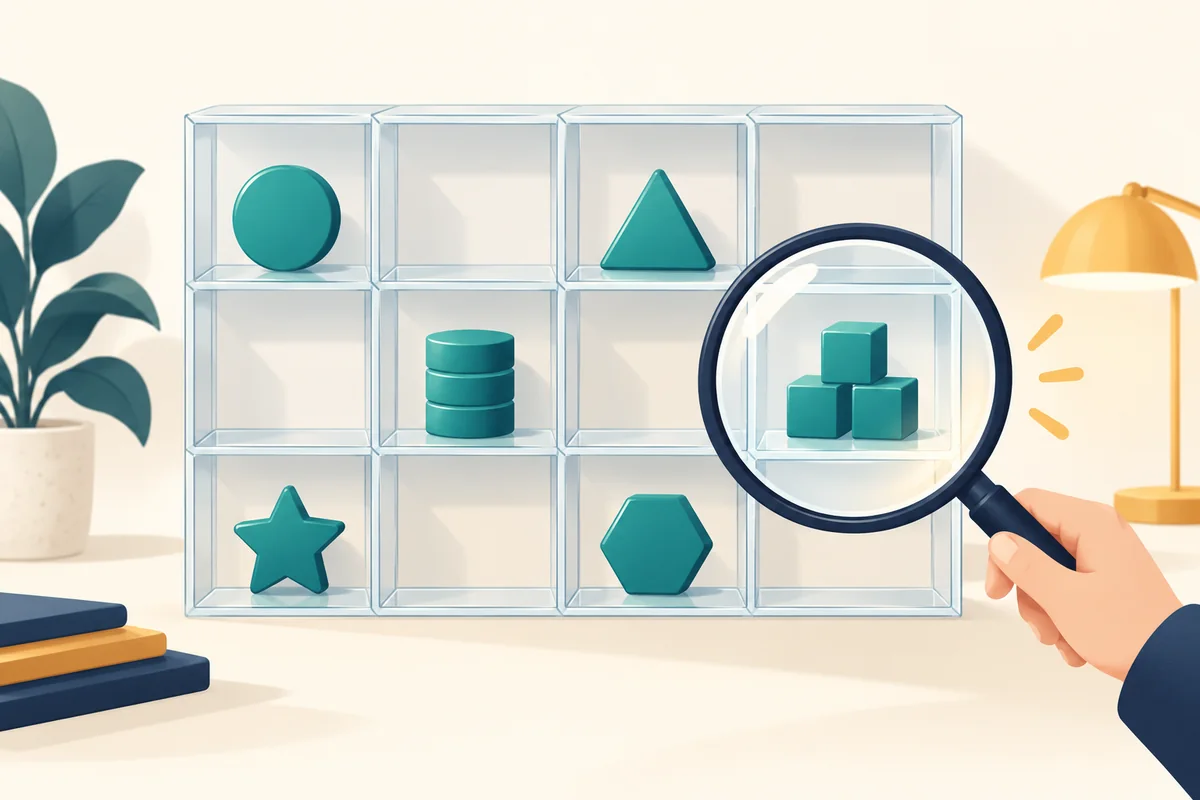
category category관측 행은 세 개지만 region에는 Jeju도 등록되어 있습니다. channel의 범주 두 개와 조합하면 분류 틀은 3×2=6칸입니다. categories에 이름이 있다는 사실이 그 조합의 데이터가 실제로 있다는 뜻은 아닙니다.
2. observed만 바꿔 집계 행 수를 비교합니다
all_groups = df.groupby(
    ["region", "channel"], observed=False, sort=True
).size()
seen_groups = df.groupby(
    ["region", "channel"], observed=True, sort=True
).size()

print("전체 범주 조합:", len(all_groups))
print(all_groups.reset_index(name="rows").to_string(index=False))
print("관측 조합:", len(seen_groups))
print(seen_groups.reset_index(name="rows").to_string(index=False))
전체 범주 조합: 6
region channel rows
Seoul web 1
Seoul app 1
Busan web 1
Busan app 0
Jeju web 0
Jeju app 0
관측 조합: 3
region channel rows
Seoul web 1
Seoul app 1
Busan web 1False 결과의 Busan·app, Jeju·web, Jeju·app은 원본에 없습니다. size가 0인 빈 조합입니다. True 결과에는 Seoul·web, Seoul·app, Busan·web의 세 조합만 나타납니다. observed는 원본 행을 만들어 내는 옵션이 아니라 집계 결과의 범주 표시 범위를 정하는 옵션입니다.
3. 빈 조합의 합계 0을 관측값 0과 섞지 않습니다
summary = df.groupby(
    ["region", "channel"], observed=False, sort=True
).agg(
    rows=("sales", "size"),
    total=("sales", "sum"),
    average=("sales", "mean")
)
print(summary.reset_index().to_string(index=False))
region channel rows total average
Seoul web 1 10 10.0
Seoul app 1 20 20.0
Busan web 1 30 30.0
Busan app 0 0 NaN
Jeju web 0 0 NaN
Jeju app 0 0 NaN이 예제에서 빈 조합은 rows=0, total=0, average=NaN입니다. 합계의 0만 보고 “그 지역의 매출이 실제 0이었다”라고 결론 내리면 안 됩니다. 행 수를 함께 확인하면 “관측 없음”과 “관측했지만 값이 0”을 구분하는 데 도움이 됩니다.
다른 집계 함수나 결측값 정책은 빈 그룹의 결과가 다를 수 있습니다. 위 출력은 size·sum·mean을 사용한 이 예제의 결과이며, NaN을 일괄 0으로 채우기 전에 보고서의 의미를 정해야 합니다.
4. 일반 문자열 열에는 같은 차이가 없습니다
plain = df.copy()
plain["region"] = plain["region"].astype("object")
plain["channel"] = plain["channel"].astype("object")

print(len(plain.groupby(
    ["region", "channel"], observed=False
).size()))
print(len(plain.groupby(
    ["region", "channel"], observed=True
).size()))
3
3observed는 범주형 그룹 키에 적용됩니다. object 문자열로 바꾼 예제에는 별도의 미사용 범주 목록이 없으므로 두 설정 모두 관측된 세 조합을 반환합니다. df.dtypes와 Series.cat.categories를 먼저 확인하세요.
모든 조합을 정해진 순서로 표시해야 하는 보고서에는 False가 적절할 수 있습니다. 실제 거래가 있었던 조합만 분석할 때는 True가 적절합니다. 여러 비범주형 키와 혼합하거나 범주가 많은 자료에서는 필요한 조합 수와 메모리도 먼저 점검하세요.
5. observed·dropna·size를 각각 결정합니다
observed는 미사용 범주 조합, dropna는 결측 그룹 키, size·count는 집계 대상의 차이입니다. 빈 조합 문제를 dropna로 해결하려고 하지 마세요. 결측 키 때문에 행이 사라지는 상황은 groupby의 dropna=False와 size·count 구분에서 이어서 확인할 수 있습니다.
정리: 범주형 여부 → 범주 목록 → observed 명시 → 결과 행 수 → 빈 그룹의 집계값 순서로 확인합니다. 실습에서는 원본을 보존하고 옵션 하나만 바꿔 결과를 비교하면 원인을 빠르게 좁힐 수 있습니다.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| pandas qcut에서 구간이 줄어들 때: duplicates·labels와 경계값 확인 (0) | 2026.10.10 |
|---|---|
| scikit-learn SimpleImputer에서 열이 사라질 때: keep_empty_features와 빈 열 (0) | 2026.10.09 |
| pandas 정수 변환 오류 해결: int64·Int64와 결측값·소수 검사 (0) | 2026.10.07 |
| pandas 날짜 변환 오류 찾기: to_datetime·NaT와 원본값 검사 (0) | 2026.10.06 |
| pandas groupby에서 행이 사라질 때: dropna=False와 size·count 구분 (0) | 2026.10.04 |


댓글