k-NN 분류에서 비용을 원에서 만원으로만 바꿨는데 예측이 달라진다면, 거리 계산에서 각 열의 크기가 어떻게 반영되는지 확인해야 합니다. 학습점과 새 입력을 모두 같은 단위로 바꿔도, 원시 유클리드 거리는 한 열의 숫자 크기가 달라지면 다른 가까움을 만들 수 있습니다. 학습 데이터로 열별 평균·표준편차를 정하고 같은 변환을 적용하는 방법을 작은 1-NN으로 비교합니다.
아래는 비용과 대기시간이라는 합성 수치 특성 두 개, A·B라는 가상 라벨을 가진 학습점 두 개입니다. 학습점을 저장하고 최근접 학습점의 라벨을 고르는 실제 로컬 1-NN 구현을 실행합니다. LLM·임베딩 API나 scikit-learn을 호출하지 않으며, 실제 업무의 정답률을 평가하는 실험도 아닙니다.
서로 다른 눈금의 자와 강아지 모형을 비교하며 특성 척도의 영향을 살펴보는 개념 그림 · 실행 수치나 실제 서비스 화면이 아닌 개념 그림입니다.
작은 반례: 같은 대상인데 가까운 학습점이 바뀝니다
학습점 A는 (1000원, 10시간), B는 (2000원, 0시간), 새 입력은 (2000원, 9시간)입니다. 원 단위에서는 A까지 비용 차이 1000이 거리의 대부분을 차지해 B를 고릅니다. 비용을 모두 10000으로 나눠 만원 단위로 표현하면 A와 새 입력의 비용 차이는 0.1이 되어 대기시간 차이가 더 크게 작용하고 A를 고릅니다.
어느 라벨이 실제로 옳은지는 이 자료에 없습니다. 여기서 확인할 것은 단위가 숫자의 크기를 바꾸고, 그 숫자를 그대로 거리로 쓰면 분류 기준이 달라진다는 사실입니다. 단위가 다른 열을 단순히 합쳤다면 모델 선택 전에 거리의 의미부터 정해야 합니다.
열별 표준화는 학습에서 정한 기준을 적용합니다
각 열에 대해 학습 평균을 빼고 학습 표준편차로 나눕니다. 이 예제는 분산을 학습 행 수로 나누는 ddof=0 기준입니다. 두 단위계의 실험에서는 학습점과 새 입력의 비용을 모두 같은 배율로 바꾼 뒤, 각 단위로 표현된 학습점에서만 평균·표준편차를 다시 구합니다. 새 입력으로 평균을 다시 학습하지 않습니다.
이렇게 변동이 있는 비용 열의 숫자와 학습 기준이 함께 환산되면 표준화한 좌표가 일치합니다. 이는 열별 z-score 변환이며, 행벡터 전체의 길이를 1로 만드는 L2 정규화와는 다른 연산입니다. 한쪽 입력만 단위를 바꾸거나 열 순서가 바뀐 문제를 표준화가 자동으로 고쳐 주지는 않습니다.
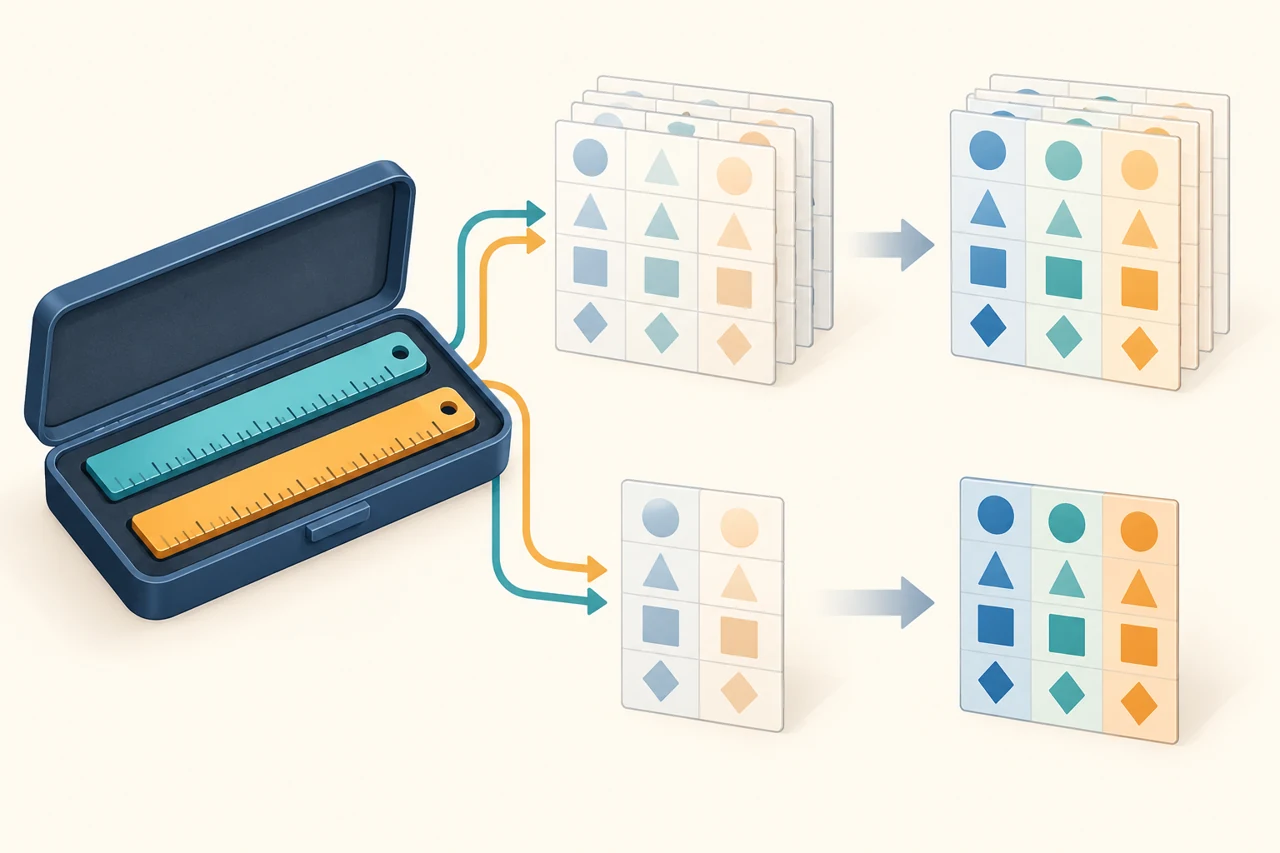
학습 데이터로 정한 열별 기준을 보관하고 같은 기준을 새 입력에 적용하는 개념 그림 · 실행 수치나 실제 서비스 화면이 아닌 개념 그림입니다.
표준 라이브러리로 1-NN과 변환을 함께 실행합니다
Python 3.14.7에서 실행했습니다. knn_units_demo.py로 저장하고 python3 knn_units_demo.py로 실행하세요. fit은 학습점과 라벨, 평균·스케일을 보관하고 predict는 그 기준으로 새 입력을 변환합니다. 원시 거리 비교에서는 평균 0·스케일 1을 사용합니다.
import math
import statistics

# Two synthetic training examples: (cost in won, waiting hours), label.
TRAIN = [(1000.0, 10.0), (2000.0, 0.0)]
LABELS = ['A', 'B']
QUERY = (2000.0, 9.0)

def checked(rows, width=None):
    rows = [tuple(float(x) for x in row) for row in rows]
    if not rows or not rows[0]:
        raise ValueError('empty data')
    width = len(rows[0]) if width is None else width
    if any(len(row) != width or not all(math.isfinite(x) for x in row)
           for row in rows):
        raise ValueError('invalid shape or nonfinite value')
    return rows

def fit(rows, labels, standardized):
    rows = checked(rows)
    if len(rows) != len(labels):
        raise ValueError('label count mismatch')
    columns = list(zip(*rows))
    means = [statistics.fmean(col) for col in columns]
    scales = [math.sqrt(statistics.fmean((x - mean) ** 2 for x in col))
              for col, mean in zip(columns, means)]
    if not standardized:
        means, scales = [0.0] * len(columns), [1.0] * len(columns)
    scales = [scale if scale != 0 else 1.0 for scale in scales]
    transformed = [tuple((x - mean) / scale
                         for x, mean, scale in zip(row, means, scales))
                   for row in rows]
    return transformed, list(labels), means, scales

def predict(model, point):
    points, labels, means, scales = model
    point = checked([point], len(means))[0]
    transformed = tuple((x - mean) / scale
                        for x, mean, scale in zip(point, means, scales))
    distances = [math.dist(row, transformed) for row in points]
    order = sorted(range(len(points)), key=lambda i: distances[i])
    if len(order) > 1 and math.isclose(distances[order[0]], distances[order[1]]):
        raise ValueError('nearest-distance tie; choose an explicit policy')
    return labels[order[0]], distances

if __name__ == '__main__':
    for standardized in [False, True]:
        answers = []
        for unit, factor in [('won', 1.0), ('ten_thousand_won', 1 / 10000)]:
            train = [(cost * factor, hours) for cost, hours in TRAIN]
            query = (QUERY[0] * factor, QUERY[1])
            answer, distances = predict(fit(train, LABELS, standardized), query)
            answers.append(answer)
            print('standardized=', standardized, 'unit=', unit,
                  'distances=', [round(x, 6) for x in distances], 'class=', answer)
        assert answers == (['B', 'B'] if standardized else ['B', 'A'])
    constant = fit([(1.0, 7.0), (3.0, 7.0)], LABELS, True)
    print('constant-column scale=', constant[3][1])
    assert constant[3][1] == 1.0
    try:
        predict(fit(TRAIN, LABELS, True), (math.nan, 9.0))
    except ValueError:
        print('nonfinite query: REJECTED')
실제 출력: 원시 거리의 반전과 표준화 후 일치
standardized= False unit= won distances= [1000.0005, 9.0] class= B
standardized= False unit= ten_thousand_won distances= [1.004988, 9.0] class= A
standardized= True unit= won distances= [2.009975, 1.8] class= B
standardized= True unit= ten_thousand_won distances= [2.009975, 1.8] class= B
constant-column scale= 1.0
nonfinite query: REJECTED
원시 거리에서는 원 단위가 B, 만원 단위가 A를 고릅니다. 표준화하면 두 단위계 모두 A까지 약 2.009975, B까지 1.8이어서 B를 고릅니다. 이 일치는 두 특성이 학습에서 변동하고 학습·입력의 단위를 함께 맞춘 이번 반례에 대한 검산입니다. 표준화가 B라는 정답을 발견했다는 의미는 아닙니다.
상수열·이상값·결측값의 규칙은 별도입니다
학습 표준편차가 0인 열은 코드에서 스케일을 1로 둡니다. 7·7처럼 학습 값이 같으면 0으로 나눌 수 없기 때문입니다. 이 열에 새 값이 들어왔을 때까지 거리의 단위 불변성을 일반화하지 않습니다. 상수열을 제거할지, 값 변화를 경고할지 같은 입력 계약을 별도로 정해야 합니다.
코드는 빈 자료·열 수 불일치·비유한 수를 거부하고, 최근접 거리가 math.isclose 기준으로 같거나 가까우면 명시적인 동점 정책을 요구합니다. 이것은 이 실습의 계약입니다. 실제 scikit-learn StandardScaler의 결측 처리까지 동일하게 재현한 구현이 아닙니다. 범주형 입력·희소 행렬·아주 큰 수의 오버플로·많은 학습점의 검색 성능도 다루지 않습니다.
평균·표준편차는 이상값에 민감하고, 업무상 특성의 중요도를 같은 변동 척도로 두는 것이 늘 최선은 아닙니다. 다른 스케일러·거리·k를 고를 때는 적절한 검증 자료로 비교해야 합니다. 정확도 향상이나 운영 비용 절감을 이번 두 점만으로 약속하지 않습니다.
보관할 결과물과 다음 점검
실제 적용에서는 특성 이름·순서·단위, 학습 평균·스케일과 학습점을 하나의 버전으로 보관하세요. 새 입력의 단위를 먼저 확인하고 같은 변환을 적용합니다. 학습과 평가에 어떤 행을 사용하는지는 전처리의 fit·transform과 누수 실습에서 이어서 확인할 수 있습니다.
k-NN의 거리는 숫자 표현과 특성 척도의 영향을 받습니다. 단위 계약을 맞춘 뒤 학습에서 정한 열별 기준을 적용하고, 수치 일치 확인과 예측 성능 평가는 분리하세요.
'자격증 > 빅데이터 분석 기사' 카테고리의 다른 글
| 빅데이터분석기사 필기 복습표: 통계·모형 평가 빈칸과 정답 (0) | 2026.10.31 |
|---|---|
| AI 결정트리 확률 1.0이면 확실할까? 리프 표본 수와 미관측 입력 실습 (0) | 2026.10.29 |
| KFold에서 shuffle=False면 시간 누수가 없을까? 학습·검증 인덱스 확인 (0) | 2026.10.24 |
| pandas groupby 결과를 원본에 붙일 때 NaN이 생기는 이유: transform과 인덱스 정렬 (0) | 2026.10.18 |
| pandas pivot 중복 오류 해결: pivot_table로 바꾸기 전에 집계 기준 확인 (0) | 2026.10.16 |


댓글